Fine-Tuning lohnt sich, wenn Sie dauerhaft ein bestimmtes Verhalten, ein festes Format oder Compliance-Konformität eines LLM benötigen. Reicht die Aufgabe mit gutem Prompting oder mit Retrieval-Augmented Generation (RAG), sollten Sie zuerst diesen Weg testen, denn er kostet weniger und liefert schneller Ergebnisse. Ein LLM-Feintuning-Projekt im Unternehmen zahlt sich vor allem bei hoher Nutzungsfrequenz und klaren, wiederholbaren Aufgaben aus. Den praktischen Projektfahrplan dazu finden Sie weiter unten.
Kurz gesagt:
- Wenn das Modell konstant falsches Verhalten zeigt oder einem festen Format folgen muss, lohnt sich Feintuning bei regelmäßig wiederkehrenden Aufgaben mit hohem Volumen.
- Bei Wissenslücken oder aktuellen Fakten ist eine Kombination aus Retrieval-Augmented Generation (RAG) und Feintuning sinnvoller, um Effizienz und Genauigkeit zu maximieren.
- Für strukturierte Ausgaben im festen Format und regulierte Branchen ist Feintuning zuverlässiger, während RAG vor allem bei kurzen, variablen Fragen geeignet ist.
- Die meisten Unternehmen profitieren bei mindestens zwei der vier Kriterien—Häufigkeit, Format, Compliance, Kosten—von einem Feintuning-Projekt, sonst sind Tests mit RAG ausreichend.
- Full Fine-Tuning ist nur bei sehr großem Volumen oder speziellen Fachsprachen wirtschaftlich, während PEFT-Methoden wie LoRA und QLoRA die Einstiegshürde durch geringeren Ressourcenbedarf senken.
Inhaltsverzeichnis
- Wann lohnt sich Fine-Tuning statt Prompting oder RAG?
- Welche geschäftlichen Vorteile bringt Fine-Tuning konkret?
- Full Fine-Tuning, SFT oder PEFT: Welche Methode passt?
- Wie bereiten Sie Trainingsdaten für Fine-Tuning vor?
- Wie läuft ein Fine-Tuning-Projekt von Pilot zu Produktion?
- Welche Risiken birgt Fine-Tuning und wie steuern Sie diese?
- Wie begleitet Outwork Fine-Tuning-Projekte in der Praxis?
- Perspektive: Was ein Projektleiter aus Fine-Tuning-Projekten lernt
- Wie unterstützt Outwork Sie beim Fine-Tuning Ihres LLM?
- Quellen
- FAQ
Wann lohnt sich Fine-Tuning statt Prompting oder RAG?
Die Kernfrage lautet: Fehlt dem Modell Wissen, oder verhält es sich falsch? Kennt ein Modell bestimmte Fakten nicht, etwa aktuelle Vertragsklauseln oder interne Produktdaten, ist RAG fast immer die bessere erste Wahl. Verhält sich das Modell hingegen konsequent falsch, ignoriert ein vorgegebenes Format oder antwortet in einem Tonfall, der nicht zur Marke passt, hilft RAG kaum. Genau hier setzt Fine-Tuning an.
Branchenleitfäden empfehlen deshalb, Fine-Tuning nicht als ersten Schritt zu wählen. Ein Modell trainieren kostet Zeit, Daten und Geld, bevor überhaupt ein Ergebnis feststeht. RAG und Fine-Tuning ergänzen sich in der Praxis: RAG liefert Fakten, Fine-Tuning formt Verhalten und Struktur. Viele Unternehmen kombinieren beides, etwa ein feingetuntes Modell mit fester Antwortstruktur, das zusätzlich per RAG auf aktuelle Dokumente zugreift.
Vier Kriterien helfen bei der Einordnung:
- Häufigkeit der Aufgabe: Läuft eine Aufgabe hundertfach täglich mit demselben Muster, rechtfertigt das den Trainingsaufwand. Einzelfälle lohnen sich selten.
- Formatkonstanz: Muss die Ausgabe strikt einem Schema folgen, etwa einem JSON-Format für nachgelagerte Systeme, ist Fine-Tuning oft zuverlässiger als Prompt-Anweisungen allein.
- Compliance-Notwendigkeit: Wenn ein Modell in regulierten Bereichen wie Finanzberatung oder Personalwesen niemals bestimmte Formulierungen verwenden darf, lässt sich das über Training robuster verankern als über einen Systemprompt, der bei langen Konversationen an Wirkung verliert.
- Latenz und Kosten pro Anfrage: Lange, RAG-gestützte Prompts mit viel Kontext verursachen bei hohem Volumen erhebliche Token-Kosten. Ein kleineres, feingetuntes Modell kann bei gleicher Aufgabe günstiger und schneller antworten.
Erfüllt Ihre Anwendung mindestens zwei dieser vier Punkte deutlich, ist Fine-Tuning wirtschaftlich meist vertretbar. Bei nur einem Punkt lohnt sich zunächst ein Test mit RAG-Architektur und optimiertem Prompting, bevor Sie in ein Trainingsprojekt investieren.
Welche geschäftlichen Vorteile bringt Fine-Tuning konkret?
Der wirtschaftliche Nutzen zeigt sich selten im Modell selbst, sondern in der Prozesskonsistenz, die es erzeugt. Ein Support-Team, das täglich hunderte Anfragen nach demselben Muster beantwortet, profitiert von einem Modell, das nicht bei jeder zehnten Anfrage vom vorgegebenen Ton abweicht.
Typische Use Cases in Unternehmen sehen so aus:
- Support-Bots mit Markenstimme: Ein feingetuntes Modell antwortet konsistent im Tonfall des Unternehmens, ohne dass jede Anfrage einen langen Systemprompt mit Beispielen mitschleppen muss.
- Vertragsprüfung und Klausel-Erkennung: Rechtsabteilungen trainieren Modelle darauf, bestimmte Risikoklauseln zuverlässig zu markieren, oft präziser als generische Prompts es leisten.
- Automatisiertes Reporting: Modelle, die aus Rohdaten strukturierte Berichte in einem festen Format erzeugen, sparen manuelle Nacharbeit in Finanz- und Controlling-Teams.
- Klassifikation grosser Textmengen: E-Mails, Tickets oder Dokumente werden nach festen Kategorien sortiert, ein klassischer Fall für kleinere, spezialisierte Modelle statt grosser Allzweck-LLMs.
- Strukturierte Formatausgaben: Wenn nachgelagerte Systeme exakt definierte JSON- oder XML-Strukturen erwarten, reduziert Training die Fehlerquote gegenüber reinem Prompting deutlich.
Der wirtschaftliche Hebel liegt in drei Bereichen: Konsistenz über tausende Anfragen hinweg, Skalierbarkeit ohne wachsende Prompt-Komplexität und geringere Latenz, weil kürzere Eingaben schneller verarbeitet werden als lange, kontextreiche RAG-Prompts.
Profi-Tipp: Rechnen Sie vor dem Start einen Business Case pro Anfrage, nicht nur pro Projekt. Ein Modell, das bei 50.000 monatlichen Anfragen auch nur zwei Cent pro Anfrage spart, amortisiert ein mittleres Trainingsprojekt oft innerhalb weniger Monate.
Ein Pilot ist wirtschaftlich sinnvoll, sobald sich die Aufgabe klar abgrenzen lässt und ein Volumen vorliegt, das den Trainingsaufwand über die Zeit rechtfertigt. Bei unklaren, sich häufig ändernden Anforderungen ist der Return dagegen unsicher. Halluzinationsraten sind ein ständiges Thema bei LLM-Anwendungen, wie Benchmark-Daten zu Halluzinationsraten zeigen. Ein gut trainiertes, eng fokussiertes Modell reduziert dieses Risiko oft stärker als ein breit angelegtes Allzweckmodell mit langem Prompt.
Full Fine-Tuning, SFT oder PEFT: Welche Methode passt?
Drei technische Ansätze dominieren die Praxis, und sie unterscheiden sich stark im Ressourcenbedarf. Full Fine-Tuning passt alle Parameter eines Modells an. Das liefert oft die stärkste Anpassung, verlangt aber erhebliche Rechenleistung und mehrere leistungsstarke GPUs über Stunden oder Tage. Für die meisten Unternehmen ist das wirtschaftlich kaum zu rechtfertigen, ausser bei sehr grossem Volumen oder hochspezialisierten Anforderungen.
Supervised Fine-Tuning (SFT) trainiert ein vortrainiertes Modell mit kuratierten Beispielpaaren aus Eingabe und gewünschter Ausgabe. Es ist der Standardweg, um einem Modell ein bestimmtes Antwortverhalten beizubringen, etwa einen Support-Ton oder ein Berichtsformat.
PEFT (Parameter-Efficient Fine-Tuning) verändert nur einen kleinen Teil der Modellparameter und lässt den Rest unverändert. Die zwei wichtigsten Varianten:
- LoRA (Low-Rank Adaptation): Fügt kleine, trainierbare Zusatzmatrizen in bestehende Modellschichten ein, statt das gesamte Modell neu zu berechnen.
- QLoRA: Kombiniert LoRA mit einer quantisierten, speicherreduzierten Modellversion und macht Training so auf deutlich günstigerer Hardware möglich.
Aktuelle Forschung zu PEFT-Methoden zeigt, dass LoRA und QLoRA die Eintrittsbarriere für Unternehmen stark gesenkt haben. Viele Anpassungen, die früher einen Serverpark verlangten, laufen heute mit deutlich reduziertem Compute-Bedarf, teils auf einer einzelnen leistungsfähigen GPU.
Für die überwiegende Mehrheit der Unternehmensanwendungen genügt PEFT völlig. Full Fine-Tuning lohnt sich fast nur, wenn ein Modell grundlegend neues Fachvokabular oder eine völlig neue Domäne lernen muss, etwa medizinische Fachsprache in einer bislang allgemeinen Domäne.
Auf der Infrastrukturseite braucht ein produktionsreifes Training mehr als nur ein Trainingsskript. Werkzeuge wie Kubeflow bilden die Trainer-Komponenten und Pipelines ab, die Versionierung, Ressourcenverteilung und Wiederholbarkeit im Training absichern. Cloud-Anbieter wie Microsoft listen über ihr Partnernetzwerk entsprechende Lösungen für Data & AI, die Fine-Tuning und Deployment als verwaltete Services anbieten, was den eigenen Infrastrukturaufwand deutlich senkt.
Wie bereiten Sie Trainingsdaten für Fine-Tuning vor?
Die Qualität der Trainingsdaten entscheidet über den Projekterfolg stärker als die gewählte Methode. Ein technisch perfekt ausgeführtes LoRA-Training mit schlechten Daten liefert ein schlechtes Modell, das ist keine Ausnahme, sondern die Regel.
Für Unternehmensanwendungen braucht es meist drei Datentypen:
- Paired Examples: Eingabe-Ausgabe-Paare, die exakt das gewünschte Verhalten zeigen, etwa eine Kundenanfrage und die ideale Antwort im Firmenton.
- Instruction-Style-Daten: Aufgabenbeschreibung plus Beispielausführung, nützlich, wenn ein Modell verschiedene Aufgabentypen unterscheiden lernen soll.
- Strukturierte Formate: JSON-Schemas oder feste Vorlagen, wenn die Ausgabe direkt in ein anderes System einfliesst.
Zur Datenmenge gibt es keine feste Regel für jeden Fall, aber PEFT-Ansätze kommen häufig schon mit einigen hundert bis wenigen tausend qualitativ guten Beispielen aus, während Full Fine-Tuning deutlich mehr verlangt. Wichtiger als die reine Menge ist die Konsistenz: Widersprüchliche Beispiele im Trainingssatz verwirren ein Modell stärker als zu wenige Daten.
Qualitätsprüfung und Annotation sollten nicht nebenbei laufen. Ein zweistufiger Review, bei dem eine zweite Person stichprobenhaft die Label prüft, deckt systematische Fehler auf, bevor sie sich im Modell festsetzen. Für offene, nicht-sensible Textquellen als Ergänzung zu firmeneigenen Daten dient etwa Common Crawl häufig als Referenz für Preprocessing-Techniken, allerdings nie als Ersatz für eigene, geprüfte Geschäftsdaten.
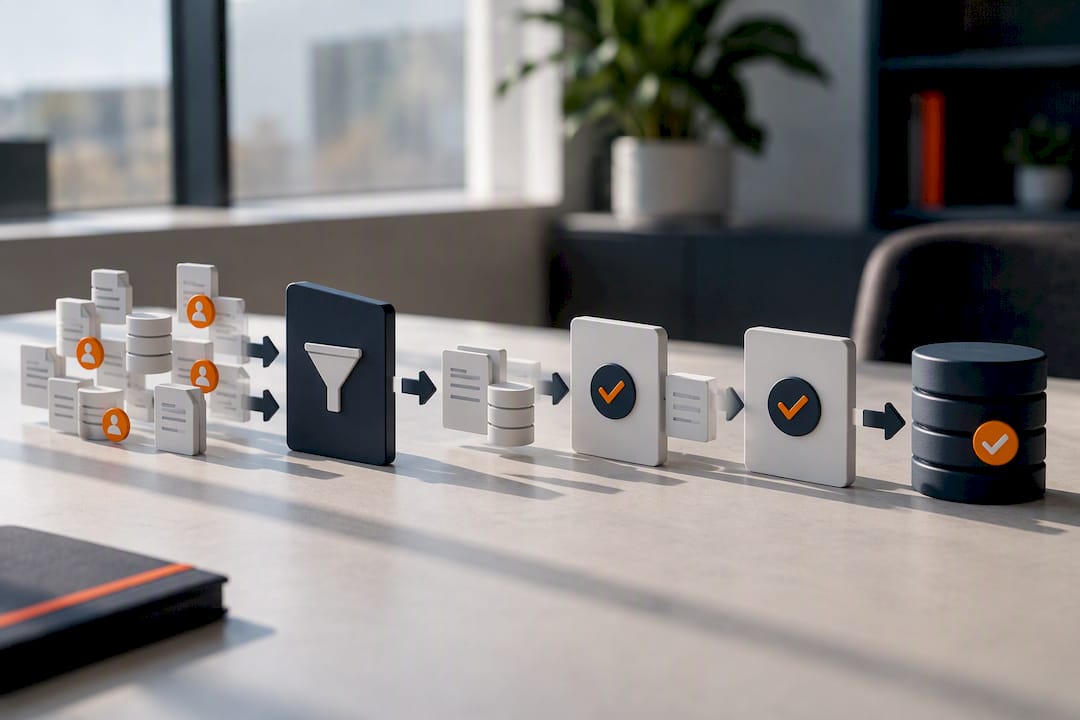
Datenschutz verdient hier besondere Aufmerksamkeit. Personenbezogene Daten in Trainingsbeispielen müssen vor dem Training pseudonymisiert oder entfernt werden, sonst landen Namen, Adressen oder Vertragsdetails dauerhaft im Modellverhalten. Ein Audit-Trail, der dokumentiert, welche Daten wann von wem freigegeben wurden, ist keine Bürokratie, sondern schützt bei einer späteren Datenschutzprüfung. Die Rechteklärung an den Ursprungsdaten, insbesondere bei Kundendaten oder Drittanbieter-Content, muss vor Trainingsbeginn abgeschlossen sein, nicht danach. Eine strukturierte Data-Governance-Roadmap hilft, diese Schritte nicht im Projektstress zu übergehen.
Wie läuft ein Fine-Tuning-Projekt von Pilot zu Produktion?
Ein realistischer Projektfahrplan gliedert sich in sechs Phasen, die selten linear, sondern meist mit Rücksprüngen verlaufen.
- Zieldefinition: Legen Sie ein messbares Erfolgskriterium fest, etwa eine Format-Compliance von 95 % statt einer vagen Verbesserung der Antwortqualität.
- Proof of Concept (PoC): Ein kleines Datenset, ein PEFT-Lauf, erste manuelle Bewertung. Ziel ist ein schneller Realitätscheck, keine Produktionsreife.
- Training: Der eigentliche Fine-Tuning-Lauf mit dem kuratierten Datensatz, meist mehrere Iterationen mit Anpassungen an Lernrate und Datenmix.
- Validierung: Test gegen einen zurückgehaltenen Datensatz sowie gegen reale, bislang unbekannte Anfragen aus dem Geschäftsalltag.
- Rollout: Stufenweise Einführung, oft zunächst für einen Teil der Anfragen parallel zum bisherigen System, um Risiken zu begrenzen.
- Monitoring: Laufende Beobachtung im Produktivbetrieb, nicht nur einmalige Abnahme.
Die wichtigsten Metriken über alle Phasen hinweg sind Genauigkeit gegenüber der erwarteten Antwort, Format-Compliance bei strukturierten Ausgaben, Latenz pro Anfrage, Kosten pro Anfrage und die Drift-Rate, also wie stark sich die Modellqualität über Wochen und Monate verschlechtert, wenn sich reale Anfragen von den Trainingsdaten entfernen.
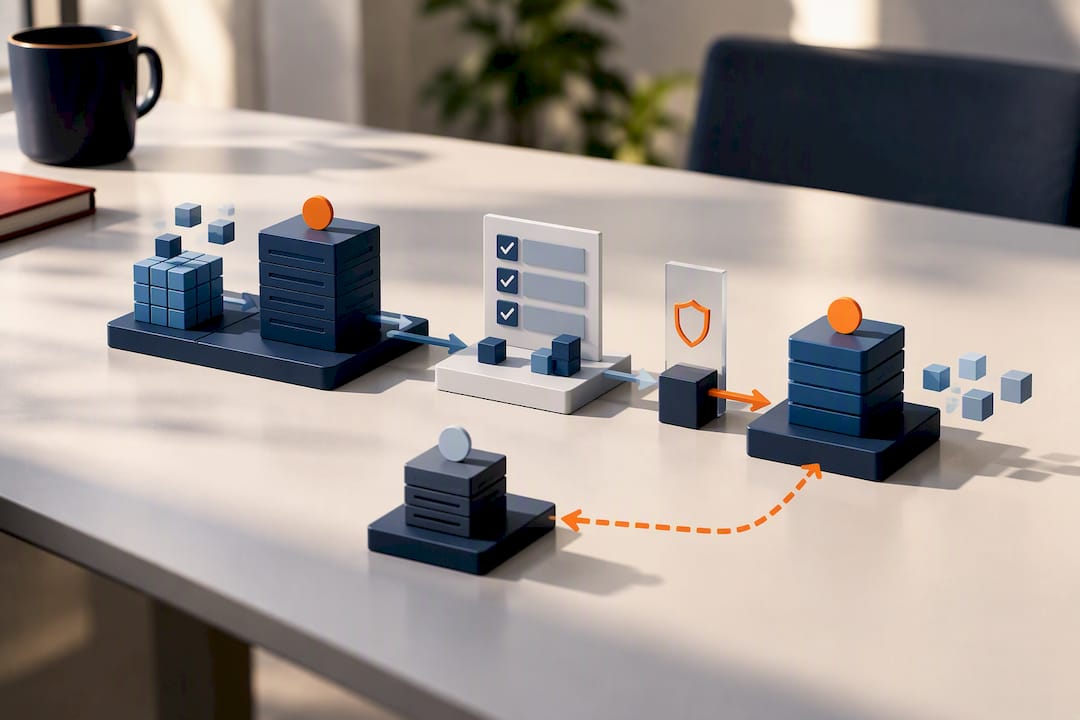
Auf der Betriebsseite braucht produktives Fine-Tuning dieselbe Disziplin wie klassische Softwareentwicklung. Versionierung jedes Trainingslaufs mit den zugehörigen Daten und Hyperparametern ist Pflicht, sonst lässt sich ein Regressionsfehler später nicht zurückverfolgen. Ein CI/CD-Prozess für Modelle, der neue Versionen automatisiert gegen einen Testkatalog prüft, bevor sie live gehen, verhindert böse Überraschungen im Produktivsystem. Und ein klarer Rollback-Plan, der binnen Minuten auf die vorherige Modellversion zurückschaltet, gehört ebenso zur Grundausstattung wie ein funktionierendes Monitoring-Dashboard für die genannten Metriken.
Welche Risiken birgt Fine-Tuning und wie steuern Sie diese?
Halluzinationen bleiben auch nach Fine-Tuning ein Thema, sie verschwinden nicht automatisch durch Training. Benchmark-Statistiken zu Halluzinationsraten zeigen, wie häufig Modelle plausibel klingende, aber falsche Aussagen produzieren, ein Risiko, das bei spezialisierten, gut getesteten Modellen tendenziell kleiner, aber nie vollständig ausgeschlossen ist.
Konkrete Governance-Bausteine helfen, dieses Risiko handhabbar zu machen:
- Testkatalog gegen Halluzinationen: Ein fester Satz kritischer Testfragen, gegen den jede neue Modellversion vor dem Rollout automatisch geprüft wird.
- Bias-Prüfung: Stichprobenartige Tests mit unterschiedlichen Nutzergruppen und Formulierungen, um systematische Verzerrungen früh zu erkennen.
- Datenherkunft dokumentieren: Jede Datenquelle, die ins Training einfliesst, muss nachvollziehbar mit Ursprung und Freigabe erfasst sein.
- Rechtsprüfung vor Trainingsstart: Klären Sie, ob Kundendaten, Drittanbieter-Content oder interne Dokumente überhaupt für Training genutzt werden dürfen.
- Auftragsverarbeitungsverträge (AVV): Wird ein externer Dienstleister für Training oder Hosting eingebunden, braucht es einen AVV, der Datenschutzpflichten klar regelt.
- Lizenzprüfung bei Trainingsdaten: Nicht jede öffentlich verfügbare Textquelle darf uneingeschränkt für kommerzielles Training verwendet werden, das gilt besonders für Bilder, Code und urheberrechtlich geschützte Texte.
Eine solide Datensicherheitsstrategie für die zugrunde liegende Softwarearchitektur ergänzt diese organisatorischen Massnahmen um die technische Seite, etwa Zugriffskontrollen auf Trainingsdaten und verschlüsselte Speicherung von Modell-Checkpoints.
Wie begleitet Outwork Fine-Tuning-Projekte in der Praxis?
Ein Fine-Tuning-Projekt scheitert selten an der Modellwahl, meist an fehlender Struktur zwischen den Phasen: unklare Übergabe von der Datenaufbereitung ins Training, kein definierter Testkatalog vor dem Rollout, kein Verantwortlicher für das laufende Monitoring. Outwork begleitet Unternehmen über den gesamten Ablauf, von der ersten Zieldefinition über Datenaufbereitung und Training bis zu Deployment und laufendem Betrieb.
Das Unternehmen besitzt Erfahrung mit unterschiedlich komplexen Digitalisierungsprojekten, die sich auf die technischen Anforderungen eines Fine-Tuning-Vorhabens übertragen lassen, etwa saubere Datenpipelines, nachvollziehbare Versionierung und stabile Produktionsumgebungen.
Eine Checkliste für die ersten Abstimmungsgespräche mit einem Technologiepartner:
- Ist das Geschäftsziel als messbare Metrik formuliert, nicht nur als vage Verbesserung?
- Liegen die Trainingsdaten bereits in ausreichender Qualität vor, oder braucht es zuerst eine Aufbereitungsphase?
- Ist die Datenschutzlage geklärt, inklusive Rechten an den verwendeten Quellen?
- Gibt es eine Entscheidung, ob PEFT ausreicht oder ob Full Fine-Tuning nötig ist?
- Wer übernimmt nach dem Rollout das laufende Monitoring und die Modellpflege?
Perspektive: Was ein Projektleiter aus Fine-Tuning-Projekten lernt
Die meisten gescheiterten Projekte scheitern nicht an der Technik, sondern an der Vorbereitung. Ein Team startet mit unklarem Ziel, sammelt Daten ohne Qualitätskontrolle und wundert sich dann, warum das Modell inkonsistent bleibt. Das ist kein technisches Problem, das ist ein Governance-Problem, das schon vor dem ersten Trainingslauf entstanden ist.
Adoption entscheidet oft mehr als Modellqualität. Ein technisch gutes Modell, das niemand im Support-Team versteht oder dem niemand vertraut, verstaubt in der Praxis. Change-Management und ein kurzer Trainingsworkshop für die Nutzer im Betrieb sind kein Nebenschauplatz.
Die klügste Strategie bleibt: klein starten, an einer eng begrenzten Aufgabe messen, dann iterieren. Wer sofort das ganze Unternehmen umstellen will, verliert die Kontrolle über genau die Metriken, die am Ende über Erfolg oder Misserfolg entscheiden.
— Outwork
Wie unterstützt Outwork Sie beim Fine-Tuning Ihres LLM?
Outwork begleitet Sie als Schweizer Technologiepartner durch den gesamten Weg vom ersten Datenset bis zum laufenden Betrieb im Produktivsystem, statt Sie nach der Lieferung eines Modells allein zu lassen.

Die Kernleistungen decken Beratung zur RAG-versus-Fine-Tuning-Entscheidung, Datenaufbereitung inklusive Datenschutzprüfung, das eigentliche Training mit PEFT- oder SFT-Methoden, das Deployment in Ihre bestehende Infrastruktur und den laufenden Betrieb inklusive Monitoring ab. Anders als ein reiner Modell-Anbieter, der nach dem Training abschliesst, bleibt Outwork über Softwareentwicklung und Betrieb an Ihrer Seite, mit End-to-End-Verantwortung von der Konzeption bis zum stabilen Produktivsystem. Soll das feingetunte Modell als eigenständiger Dienst betrieben werden, lässt sich das über SaaS-Entwicklung direkt anschliessen.
Wenn Sie prüfen wollen, ob sich ein Fine-Tuning-Projekt für Ihre Aufgabe wirtschaftlich rechnet, ist ein unverbindliches Erstgespräch der richtige nächste Schritt. Nehmen Sie über Outwork Kontakt auf und klären Sie gemeinsam mit Outwork, ob PEFT, Full Fine-Tuning oder eine RAG-Lösung besser zu Ihrer Situation passt.
Quellen
Für technische Teams, die tiefer in die Materie einsteigen wollen, lohnt sich der Blick in die Forschungspapiere zu Fine-Tuning-Methoden auf ArXiv, die aktuelle Fortschritte bei PEFT-Ansätzen dokumentieren. Wer produktionsreife Trainingspipelines aufbaut, findet in der Kubeflow-Dokumentation konkrete Referenzen für Trainer-Komponenten. Und für Unternehmen, die den Cloud-Weg über verwaltete Services gehen wollen, bietet Microsofts Übersicht zu Data-&-AI-Lösungspartnern einen guten Ausgangspunkt für den Vergleich verschiedener Deployment-Optionen.
- Solutions Partner for Data and AI (Azure) – Microsoft Partner
- Kubeflow Trainer Documentation
- Hallucination Benchmark Statistics – Statista
FAQ
Was sind LLM-Unternehmen?
Als LLM-Unternehmen werden meist Anbieter bezeichnet, die grosse Sprachmodelle entwickeln, hosten oder für Kunden anpassen, von Basismodell-Herstellern bis zu Beratungsfirmen, die Fine-Tuning und Deployment als Dienstleistung anbieten. Outwork gehört zur zweiten Gruppe und begleitet Unternehmen von der Datenaufbereitung bis zum Betrieb eines angepassten Modells.
Welche LLM-Anbieter gibt es?
Der Markt reicht von grossen Cloud-Plattformen mit Partnernetzwerken für Data & AI bis zu spezialisierten Beratungsfirmen, die Fine-Tuning-Projekte end-to-end umsetzen. Welcher Anbieter passt, hängt davon ab, ob Sie eine reine Infrastruktur oder eine vollständige Projektbegleitung inklusive Datenaufbereitung und Betrieb suchen.
Wie kann ich ein eigenes LLM aufbauen?
Ein eigenes, feingetuntes LLM entsteht meist nicht durch Training von Grund auf, sondern durch Anpassung eines bestehenden Basismodells mit Methoden wie LoRA oder QLoRA und einem kuratierten, unternehmenseigenen Datensatz. Der Weg führt über Zieldefinition, einen kleinen Proof of Concept, den eigentlichen Trainingslauf und anschliessende Validierung, bevor ein Rollout in den Produktivbetrieb erfolgt.
Was kostet ein LLM-Feintuning-Projekt für ein Unternehmen?
Die Kosten hängen stark von Datenmenge, gewählter Methode und Infrastruktur ab, ein PEFT-Ansatz wie QLoRA ist deutlich günstiger als Full Fine-Tuning. Konkrete Preise für ein Projekt mit Outwork sind nicht pauschal gelistet und werden nach einem Erstgespräch individuell auf Basis des Projektumfangs erstellt.
Ist Fine-Tuning oder RAG die bessere Lösung für mein Unternehmen?
Das hängt vom Problem ab: Fehlt dem Modell aktuelles Wissen, ist RAG meist die schnellere und günstigere Lösung. Muss sich das Modell dauerhaft in einem bestimmten Format oder Ton verhalten, liefert Fine-Tuning die verlässlichere Anpassung, oft in Kombination mit RAG für aktuelle Fakten.