Rate Limiting begrenzt API-Anfragen direkt am Gateway oder Proxy, setzt standardisierte Header wie RateLimit, RateLimit-Policy und Retry-After und erzwingt saubere 429-Antworten bei Überschreitung. Entscheidend sind drei Schritte: konservative Limits definieren, Standard-Header statt proprietärer X-Header nutzen und 429-Rate sowie Quota-Auslastung laufend überwachen. So bleibt die API stabil, fair verteilt und für Clients vorhersehbar.
Kurz gesagt:
- Für legitime Kurzzeitspitzen eignet sich ein Verfahren mit begrenztem Tokenvorrat; bei mehreren Gatewayinstanzen hält ein zentraler Zähler nach GCRA dasselbe Limit konsistent.
- Bei Überschreitungen sollten Clients den Status 429 und eine klare Wartezeit erhalten; standardisierte Grenzwertangaben verhindern blinde Wiederholungsversuche und erleichtern die Planung erneuter Anfragen.
- Lasttests sollten einzelne Internetadressen, Schlüssel sowie verteilte Anfragen abdecken; häufen sich legitime Ablehnungen mit Statuscode 429, hilft ein größerer Puffer für Lastspitzen.
Inhaltsverzeichnis
- Was ist Rate Limiting und wann benötigst Du es?
- Wichtige Algorithmen: Fixed Window, Sliding Window, Token Bucket, Leaky Bucket, GCRA
- Wo setzt Du Rate Limits technisch durch: Gateway, Edge, WAF oder Applikation?
- Kommunikation mit Clients: Header, Statuscodes und Dokumentation
- Design- und Betriebsregeln für zuverlässige Limits
- Testen, Messen und Monitoring: Kennzahlen und Lasttests
- Outwork-Perspektive: Wie wir Rate Limiting in Kundenprojekten angehen
- Wie wir Dich bei der Umsetzung von Rate Limiting unterstützen
- FAQ
- Quellen
Was ist Rate Limiting und wann benötigst Du es?
Rate Limiting begrenzt, wie viele Anfragen ein Client in einem bestimmten Zeitraum an eine API stellen darf. Throttling ist eng verwandt, meint aber oft die aktive Drosselung laufender Anfragen, etwa durch Verzögerung statt Ablehnung. Quotas wiederum sind längerfristige Kontingente, meist pro Tag oder Monat, während Rate Limits kurzfristige Raten pro Sekunde oder Minute regeln. Alle drei Mechanismen lassen sich kombinieren: ein Tageskontingent für die Gesamtnutzung, ein Rate Limit für Spitzen.
Gebraucht wird Rate Limiting dort, wo eine API mehr als nur interne, vertrauenswürdige Aufrufe bedient. Drei Situationen tauchen in der Praxis immer wieder auf:
- Schutz vor Überlast durch fehlerhafte Clients, Bots oder gezielte Angriffe
- Faire Ressourcenverteilung zwischen vielen Kunden oder Mandanten auf gemeinsamer Infrastruktur
- Kostenkontrolle bei Backends, die nach Rechenleistung oder externen API-Aufrufen abgerechnet werden
Die Schweizer API-Security-Guideline der Bundeskanzlei empfiehlt, Rate Limiting an Gateways, Reverse Proxies oder WAFs zu betreiben, und betont, dass bei anonymen Endpunkten die Zählung nach Client-IP besonders wichtig ist, weil kein Schlüssel oder Token zur Identifikation vorliegt. Wer ohne Rate Limiting startet, merkt die Lücke meist erst, wenn ein einzelner Client das Backend überlastet und alle anderen Nutzer darunter leiden.
Wichtige Algorithmen: Fixed Window, Sliding Window, Token Bucket, Leaky Bucket, GCRA
Die Wahl des Algorithmus bestimmt, wie genau und wie burst-tolerant ein Limit tatsächlich wirkt. Fünf Muster decken fast alle praktischen Fälle ab:
- Fixed Window: zählt Anfragen in starren Zeitfenstern, etwa pro Minute; einfach zu implementieren, erlaubt aber Doppel-Bursts an Fenstergrenzen
- Sliding Window: verschiebt das Zeitfenster kontinuierlich und glättet damit die Grenzfälle des Fixed Window, verlangt dafür mehr Rechenaufwand
- Token Bucket: füllt einen Eimer mit Tokens mit konstanter Rate; Anfragen verbrauchen Tokens, Bursts sind möglich, solange der Eimer voll ist
- Leaky Bucket: verarbeitet Anfragen mit konstanter Abflussrate und glättet Spitzen, statt sie durchzulassen
- GCRA (Generic Cell Rate Algorithm): berechnet einen theoretischen Ankunftszeitpunkt pro Anfrage und bietet hohe Genauigkeit bei geringem Speicherbedarf, bekannt durch die Implementierung Redis Cell
Bei verteilten Systemen zählt nicht nur die Formel, sondern auch, wo der Zähler liegt. Ein zentraler Zähler in Redis sorgt für Konsistenz über mehrere Instanzen, fügt aber Netzwerklatenz hinzu. Lokale Zähler pro Instanz sind schnell, können aber bei mehreren Knoten das Gesamtlimit überschreiten. API Commons beschreibt dafür ein praxisnahes Rate-Limits-Schema und empfiehlt gerade für verteilte Architekturen Algorithmen wie Redis Cell oder GCRA, da sie präziser und skalierbarer arbeiten als einfache Fixed-Window-Zähler.
Ein hybrider Ansatz löst den Zielkonflikt oft am saubersten: ein schneller lokaler Token Bucket fängt kurzfristige Bursts latenzarm ab, während ein sekundärer zentraler GCRA- oder Redis-Cell-Check die langfristige Konsistenz über alle Instanzen sicherstellt. So verhindert man sowohl Burst-Missbrauch als auch Inkonsistenzen durch Uhrdrift zwischen Servern.
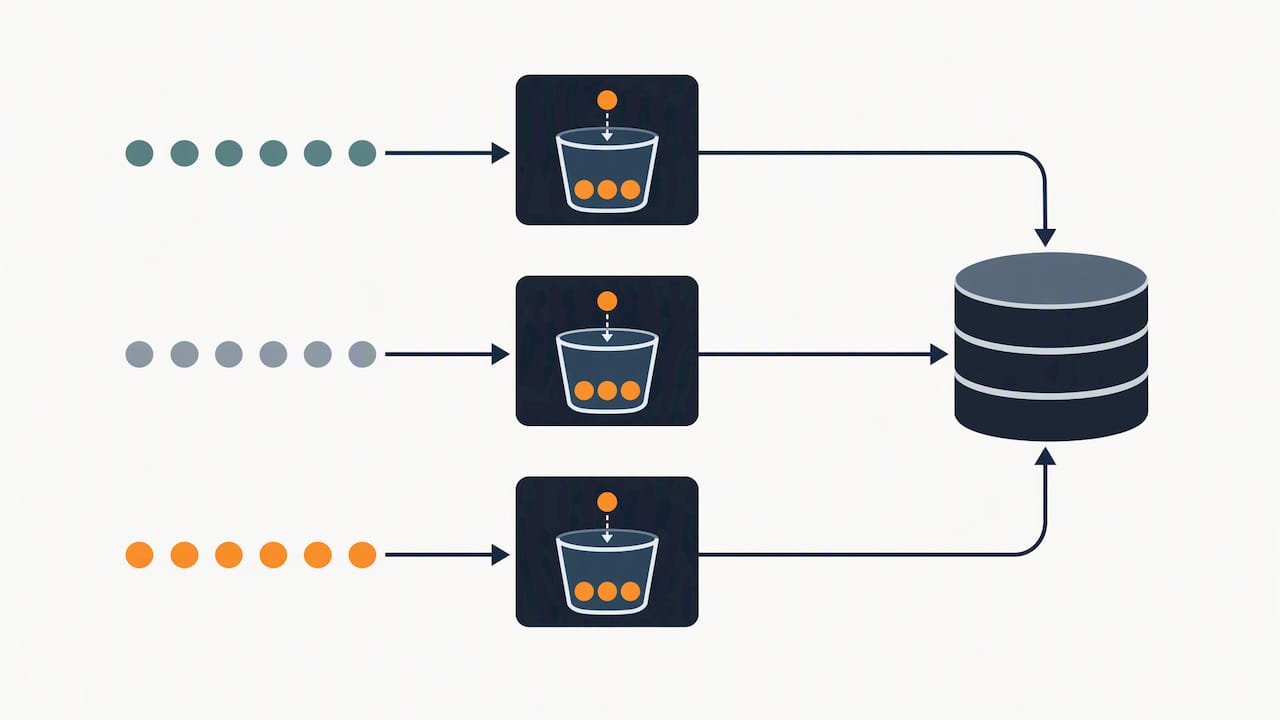
Profi-Tipp: Setze Token Bucket ein, wenn kurze Bursts legitim sind, etwa bei interaktiven Clients, und GCRA oder Redis Cell, wenn mehrere Gateway-Instanzen dasselbe Limit konsistent durchsetzen müssen.
Wo setzt Du Rate Limits technisch durch: Gateway, Edge, WAF oder Applikation?
Die Durchsetzungsebene entscheidet über Latenz, Kontextwissen und Betriebsaufwand. Vier Ebenen kommen in der Praxis typischerweise zum Einsatz, oft kombiniert:
- Edge beziehungsweise CDN: blockiert Anfragen so früh wie möglich und schützt das Backend vollständig, kennt aber selten Nutzerkontext wie Abonnementstufe oder API-Schlüssel
- API-Gateway oder Reverse Proxy: meist der beste Kompromiss, da hier Authentifizierung, Zählung und das Ausgeben von RateLimit-Headern an einer zentralen Stelle zusammenlaufen
- Web Application Firewall (WAF): ergänzt Rate Limiting oft als Sicherheitsfunktion gegen Scraping oder Credential Stuffing, meist grobkörniger als ein dediziertes Gateway
- Applikations-Layer: ermöglicht feinste Kontrolle, etwa pro Geschäftsregel oder Nutzeraktion, skaliert aber schlechter, weil jede Anwendungsinstanz synchronisiert werden muss
Die Schweizer API-Security-Guideline hält Gateway, Reverse Proxy oder WAF für die geeigneten Orte, weil sie Durchsetzung und Protokollierung von der eigentlichen Geschäftslogik trennen. Bei verteilten Systemen mit mehreren Gateway-Knoten bleibt die Konsistenzfrage zentral: ohne gemeinsamen Zählerspeicher, etwa in Redis, driften lokale Limits auseinander und ein Client kann das globale Limit durch geschicktes Verteilen seiner Anfragen auf mehrere Knoten umgehen. Für Architekturentscheidungen rund um skalierbare Webplattformen lohnt sich deshalb ein früher Blick auf die Zielarchitektur, bevor der Durchsetzungsort festgelegt wird.
Kommunikation mit Clients: Header, Statuscodes und Dokumentation
Ein Rate Limit, das Clients nicht verstehen, führt zu blindem Retry-Verhalten und unnötiger Last. RFC 6585 definiert dafür den Statuscode 429 Too Many Requests, ergänzt durch den Retry-After-Header aus RFC 9110, der Clients mitteilt, wann ein erneuter Versuch sinnvoll ist.
Für die laufende Kommunikation von Limits empfiehlt sich heute der IETF-Entwurf für RateLimit-Header, der die Felder RateLimit und RateLimit-Policy standardisiert, statt sich auf proprietäre X-RateLimit-Header zu verlassen. Praktisch bedeutet das:
- 429 plus Retry-After bei jeder Ablehnung ausgeben, damit Clients den nächsten Versuch korrekt planen
- RateLimit und RateLimit-Policy nach IETF-Entwurf bevorzugen, X-RateLimit-* nur für Abwärtskompatibilität weiterführen
- Reset-Intervalle klar benennen, etwa als Sekunden bis zum nächsten Fenster
- Fehlerantworten nach Möglichkeit als application/problem+json gemäss RFC 9457 strukturieren, damit Clients Fehler maschinenlesbar auswerten können
- Limits, Backoff-Empfehlungen und erwartetes Client-Verhalten in der API-Dokumentation festhalten
Eine transparente Dokumentation der Limits reduziert laut Praxisbeiträgen zu REST-API-Dokumentation den Supportaufwand deutlich, weil Entwickler klare Reset-Intervalle und Backoff-Regeln erwarten, statt sie durch Trial and Error herauszufinden. Wer eine API-Spezifikation ohnehin überarbeitet, findet in unserem Leitfaden zu API-Entwicklung und Sicherheit passende Hinweise zu Dokumentationsstruktur und Antwortformaten.
Design- und Betriebsregeln für zuverlässige Limits
Ein Rate Limit wirkt nur so gut wie sein Scoping. Drei Ebenen lassen sich kombinieren, je nach Anwendungsfall:
- Per-Key: Limit pro API-Schlüssel, Standard für authentifizierte Integrationen
- Per-IP: Limit pro Quell-IP, notwendig bei anonymen oder öffentlichen Endpunkten
- Per-Tenant: Limit pro Mandant in Multi-Tenant-Systemen, verhindert, dass ein Kunde die Kapazität anderer Kunden verdrängt
Quotas und Rate Limits ergänzen sich: die Quota begrenzt das Gesamtvolumen über einen längeren Zeitraum, das Rate Limit verhindert kurzfristige Spitzen innerhalb dieser Quota. Das öffentliche Geoportal Geo zeigt, wie das in der Praxis aussieht: die REST-API ist auf rund 21 Millionen Anfragen pro Jahr und 40 Anfragen pro Minute begrenzt, während die WMTS-Schnittstelle 631 Millionen Anfragen pro Jahr und 1’200 Anfragen pro Minute erlaubt, Werte, die seit 2025 gelten und öffentlich kommuniziert sind.
Burst-Management sorgt dafür, dass kurze Lastspitzen nicht sofort blockiert werden, solange der Gesamtdurchschnitt im Rahmen bleibt, etwa über einen Token Bucket mit grösserem Puffer. Für Clients, die auf 429 stossen, empfiehlt sich exponentielles Backoff mit Jitter, also eine zufällige Verzögerung zusätzlich zur wachsenden Wartezeit, um synchronisierte Wiederholungsversuche vieler Clients zu vermeiden. Diese Regel gehört in jede API-Dokumentation, ebenso wie Service-Level-Angaben zu Reset-Zeiten und erwarteter Verfügbarkeit.
Profi-Tipp: Dokumentiere Backoff-Empfehlungen als Code-Beispiel in der API-Referenz, nicht nur als Fliesstext, damit Entwickler sie direkt übernehmen können.
Testen, Messen und Monitoring: Kennzahlen und Lasttests
Ohne Messung bleibt jedes Limit eine Vermutung. Vier Kennzahlen gehören in jedes Monitoring-Dashboard für Rate Limiting, wie sie auch API Commons als übliche Metriken beschreibt:
- 429_rate: Anteil der Anfragen, die mit 429 abgelehnt werden, als Frühwarnsignal für zu enge Limits oder Missbrauch
- quota_utilization_p95: 95. Perzentil der Quota-Auslastung über alle Clients, zeigt, wie nah die meisten Nutzer am Limit liegen
- throttled_clients_unique: Anzahl eindeutiger Clients, die innerhalb eines Zeitraums gedrosselt wurden
- retry_after_compliance: Anteil der Clients, die Retry-After tatsächlich respektieren, statt sofort erneut anzufragen
Gezielt instrumentierte Lasttests, die neben reinen Request-Raten auch Retry-Verhalten und Backoff-Einhaltung messen, zeigen laut API Commons zuverlässig, ob Clients sich an Retry-After halten oder das System durch aggressive Wiederholungen zusätzlich belasten.
Lasttests sollten drei Szenarien abdecken: Last pro einzelner IP, Last pro API-Schlüssel und verteilte Last über viele gleichzeitige Clients, um zu prüfen, ob das globale Limit auch bei mehreren Gateway-Instanzen hält. Limits lassen sich danach iterativ anpassen: wer feststellt, dass die 429-Rate bei legitimen Spitzenlasten zu hoch ausfällt, lockert das Limit oder vergrössert den Burst-Puffer, statt pauschal die gesamte Policy zu ändern. SRE-Teams definieren Alerts typischerweise auf plötzliche Anstiege der 429-Rate, auf eine p95-Quota-Auslastung nahe 100 Prozent und auf sinkende Retry-After-Compliance, da letztere oft auf fehlerhafte Client-Implementierungen hinweist.
Outwork-Perspektive: Wie wir Rate Limiting in Kundenprojekten angehen
In Architektur- und SaaS-Projekten wird Rate Limiting oft direkt am API-Gateway eingesetzt, kombiniert mit einem zentralen Zähler wie Redis Cell, sobald mehrere Instanzen dasselbe Limit durchsetzen müssen. Diese Kombination hält die Latenz niedrig und sorgt gleichzeitig für Konsistenz über die gesamte Infrastruktur.
Bei der Umsetzung wird besonders auf saubere Header-Kommunikation nach aktuellem Standard und auf Metriken wie 429-Rate und Quota-Auslastung geachtet, die von Anfang an ins Monitoring aufgenommen werden, statt sie nachträglich zu ergänzen. So lässt sich ein Limit im Betrieb beobachten und anpassen, bevor es zum Problem für zahlende Kunden wird.
— Outwork
Wie wir Dich bei der Umsetzung von Rate Limiting unterstützen
Rate Limiting richtig zu dimensionieren, bedeutet, Architektur, Monitoring und API-Dokumentation gemeinsam zu denken, nicht als isolierte Aufgaben. Bei der Softwareentwicklung übernehmen wir genau diese Verbindung: von der Architekturberatung für Gateway- und Zählerdesign über die technische Umsetzung bis zur Einrichtung von Lasttests und Monitoring für 429-Rate und Quota-Auslastung.

Für API-Projekte mit höherem Skalierungsbedarf bieten wir im Rahmen unserer SaaS-Entwicklung zusätzlich Beratung zu Quota-Design und Mandantentrennung an; dabei kann auch eine Webseite Performance verbessern, um Lastspitzen effektiv zu bewältigen. Wer ein bestehendes System prüfen oder ein neues API-Projekt aufsetzen lassen möchte, kann über Outwork direkt eine Beratung anfragen.
FAQ
Was ist der Unterschied zwischen API-Throttling und Rate Limiting?
Rate Limiting legt eine feste Obergrenze an Anfragen pro Zeitraum fest und lehnt überschüssige Anfragen meist mit 429 ab. Throttling drosselt den Durchsatz aktiv, etwa durch Verzögerung statt Ablehnung, und wird oft als eine mögliche Umsetzung von Rate Limiting verstanden.
Was bedeutet TPS im Zusammenhang mit APIs?
TPS steht für Transaktionen pro Sekunde und beschreibt, wie viele Anfragen oder Operationen ein System in einer Sekunde verarbeitet. Rate Limits werden häufig in TPS oder in Anfragen pro Minute ausgedrückt, um Kapazitätsgrenzen festzulegen.
Ist HTTP 429 ein Rate-Limit-Fehler?
Ja, der Statuscode 429 Too Many Requests ist laut RFC 6585 genau für diesen Fall definiert: der Client hat innerhalb eines Zeitraums zu viele Anfragen gesendet. Server sollten dabei zusätzlich den Retry-After-Header setzen, damit der Client weiss, wann ein erneuter Versuch sinnvoll ist.
Was versteht man unter Rate Limiting?
Rate Limiting begrenzt die Anzahl der Anfragen, die ein Client innerhalb eines definierten Zeitraums an eine API senden darf. Ziel ist der Schutz der Systemverfügbarkeit, eine faire Verteilung der Ressourcen zwischen Nutzern und die Kontrolle über die Backend-Last.
Quellen
- SP1_API_Security_Guideline_v1.0 (BK)
- RateLimit Header Fields for HTTP (IETF Draft)
- Geo
- Rate Limits | API Commons
- RFC 6585 — Additional HTTP Status Codes (429 Too Many Requests)