Stoppen Sie Crawl-Verschwendung, indem Sie nicht-kanonische und nicht-indexierungswürdige URLs entfernen oder per robots.txt blockieren, und senken Sie gleichzeitig Ihre Serverantwortzeiten. Prüfen Sie den aktuellen Zustand zuerst über die Google Search Console, Server-Logfiles und PageSpeed Insights. Die folgenden Abschnitte zeigen Ihnen, wie Sie das Crawling diagnostizieren und priorisiert korrigieren.
Kurz gesagt:
- Wenn große, stark frequentierte Websites keine technischen Maßnahmen ergreifen, kann das Crawl-Budget durch Parameter, Duplicate Content oder langsame Serverantworten schnell verschwendet werden.
- Die Analyse sollte mit Crawl-Statistiken, Logfile-Auswertungen und TTFB-Messungen beginnen, um problematische URLs, hohe Antwortzeiten oder unnötige Crawl-Anfragen zu identifizieren.
- Priorisierte Optimierungen sind die Bereinigung der Sitemap, gezielte robots.txt-Blockierungen und die Verwendung von Canonicals, um unnötiges Crawling bei nicht-value-relevanten Seiten zu reduzieren.
- Langsame Serverantworten, eine fragmentierte Infrastruktur und fehlerhafte Weiterleitungen führen zu höherem Ressourcenverbrauch und verringern die Crawl-Effizienz.
Inhaltsverzeichnis
- Was ist Crawl-Budget? Crawl Capacity Limit und Crawl Demand erklärt
- Wann lohnt sich intensives Crawl-Budget-Tuning?
- Wie Sie das aktuelle Crawling messen: GSC, Logfiles, PageSpeed
- Häufige Ursachen für verschwendetes Crawl-Budget
- Priorisierte Checkliste zur Crawl-Budget-Optimierung
- Monitoring und Erfolgs-KPIs nach der Umsetzung
- Unsere Erfahrungen und eine empfohlene Audit-Routine
- Wann Crawl-Budget-Optimierung nicht oberste Priorität hat
- Outwork-Leistungen für technisches SEO und Crawl-Budget-Optimierung
- FAQ
- Quellen
Was ist Crawl-Budget? Crawl Capacity Limit und Crawl Demand erklärt
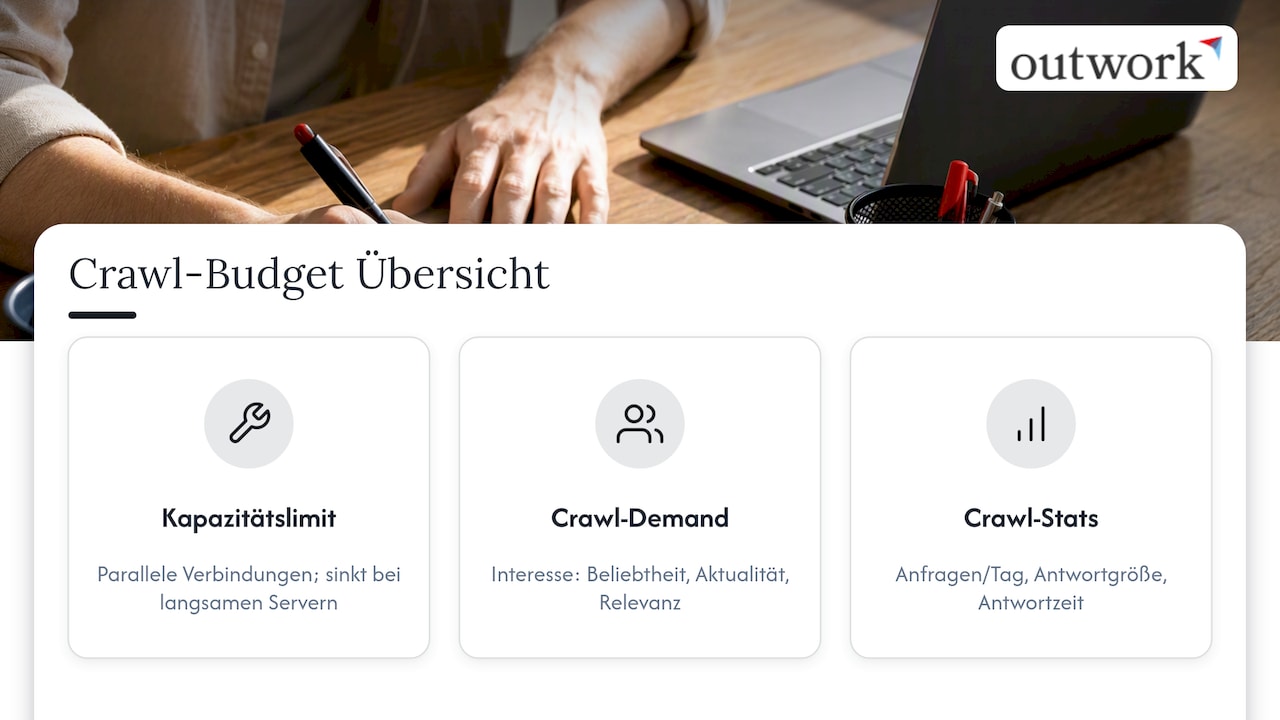
Das Crawl-Budget beschreibt, wie viele URLs Googlebot innerhalb eines bestimmten Zeitraums auf einer Website abruft. Es setzt sich aus zwei Faktoren zusammen: dem Crawl Capacity Limit und dem Crawl Demand. Das Capacity Limit beschreibt, wie viele parallele Verbindungen Googlebot zu einem Host aufbauen kann, ohne die Serverleistung zu beeinträchtigen. Reagiert ein Server langsam oder liefert er vermehrt Fehler, senkt Google diese Grenze automatisch. Crawl Demand wiederum beschreibt, wie stark Google überhaupt daran interessiert ist, eine Seite erneut zu besuchen: Beliebtheit, Aktualität und wahrgenommene Relevanz der Inhalte spielen hier eine Rolle.
Wichtig für die technische Planung: Google bewertet Hosts getrennt voneinander. Betreiben Sie mehrere Subdomains oder Mandanten auf unterschiedlicher Infrastruktur, besitzt jeder Host sein eigenes Crawl-Budget. Eine zentrale, performante Hosting-Architektur wirkt sich daher direkt auf die Crawl-Kapazität aus, während eine fragmentierte Infrastruktur das verfügbare Budget unnötig aufteilt.
Der Crawl Stats Report in der Search Console macht diese Mechanik sichtbar. Er zeigt, wie viele Anfragen Googlebot täglich stellt, wie gross die abgerufenen Antworten sind und wie lange der Server im Durchschnitt braucht, um zu antworten. Diese drei Werte bilden die Grundlage jeder weiteren Analyse, denn ohne sie bleibt jede Optimierung reine Spekulation. Ein wichtiger Hinweis vorab: robots.txt eignet sich nicht als kurzfristiges Werkzeug, um Budget gezielt umzuverteilen. Google weist freigewordenes Budget nicht automatisch anderen Seiten zu, wenn Sie Bereiche blockieren.
Wann lohnt sich intensives Crawl-Budget-Tuning?
Nicht jede Website braucht eine aufwendige Crawl-Optimierung. Relevant wird das Thema vor allem bei grossen E-Commerce-Plattformen, Marktplätzen und Portalen mit facettierter Navigation, bei denen Filter- und Sortierkombinationen Zehntausende zusätzlicher URL-Varianten erzeugen können. Auch Websites mit mehreren hunderttausend Seiten, häufig wechselndem Content oder starkem internationalem Rollout profitieren spürbar.
Ein paar Signale in Search Console und Logfiles sollten Sie aufhorchen lassen: ein deutlicher Anstieg der durchschnittlichen Antwortzeit, ein wachsender Anteil an 4xx- oder 5xx-Antworten, oder eine Diskrepanz zwischen stark steigenden Crawl-Anfragen und stagnierender Indexierung. Diese Muster deuten darauf hin, dass Googlebot Ressourcen auf Seiten verwendet, die keinen Mehrwert liefern.
Die Priorisierungsregel ist einfach formuliert: Konzentrieren Sie sich zuerst darauf, Crawl Demand für Ihre wichtigsten, umsatz- oder trafficrelevanten Seiten zu erhöhen, und erst danach auf die Reduktion von Verschwendung bei Randseiten. Kleine Blogs oder Broschürenseiten mit wenigen hundert URLs erreichen das Crawl Capacity Limit in aller Regel nie.
Wie Sie das aktuelle Crawling messen: GSC, Logfiles, PageSpeed
Bevor Sie irgendetwas ändern, brauchen Sie eine Bestandsaufnahme. Drei Quellen liefern dafür die nötigen Daten.
Der Crawl Stats Report in der Google Search Console zeigt die Gesamtzahl der Crawl-Anfragen, die durchschnittliche Antwortzeit und die durchschnittliche Download-Grösse pro Antwort, aufgeschlüsselt nach Googlebot-Typ (mobil und Desktop), Dateityp und Antwortcode. Ein Blick in die Beispiel-URLs zeigt oft sofort, welche Seitentypen überproportional häufig besucht werden, obwohl sie keinen echten Wert liefern.
Server-Logfiles ergänzen dieses Bild, weil sie jeden einzelnen Zugriff von Googlebot protokollieren, nicht nur eine Stichprobe. Sie beantworten Fragen wie: Welche URL-Muster werden am häufigsten besucht? Wie oft kehrt Googlebot zu bereits bekannten Seiten zurück, statt neue zu entdecken? Gibt es Bereiche, die trotz robots.txt-Sperre weiterhin angefragt werden?
PageSpeed Insights und Lighthouse zeigen die Time to First Byte (TTFB) sowie Rendering-Kosten durch JavaScript und CSS. Eine hohe TTFB wirkt sich direkt auf das Crawl Capacity Limit aus, da langsame oder fehlerhafte Serverantworten Google dazu veranlassen, die Crawl-Frequenz zu reduzieren.
Eine kompakte Startchecklist für die erste Woche:
- Crawl Stats Report in der Search Console auf Trends bei Anfragen und Antwortzeit prüfen.
- Logfiles der letzten 30 Tage nach den am häufigsten gecrawlten URL-Mustern filtern.
- TTFB über PageSpeed Insights für die zehn wichtigsten Seitentypen messen.
- Anteil von 4xx- und 5xx-Antworten im Crawl Stats Report dokumentieren.
- Aktuelle robots.txt und XML-Sitemap gegen die tatsächliche Seitenstruktur abgleichen.
Häufige Ursachen für verschwendetes Crawl-Budget
Die meisten Probleme lassen sich auf eine Handvoll wiederkehrender Muster zurückführen.
- Parameter-URL-Explosion: Filter, Sortierungen und Session-IDs erzeugen oft Tausende technisch unterschiedlicher URLs mit identischem oder sehr ähnlichem Inhalt.
- Duplicate Content und fehlerhafte Canonicals: Wenn mehrere URL-Varianten auf dieselbe Ressource verweisen, aber kein konsistentes Canonical-Tag gesetzt ist, crawlt Googlebot jede Variante einzeln.
- Weiterleitungsketten und Soft-404s: Mehrstufige Redirects verbrauchen pro Zielseite mehrere Anfragen, während Soft-404-Seiten fälschlich als gültig behandelt werden und wiederholt besucht werden.
- Fehlerhafte robots.txt-Konfiguration: Eine zu grosszügige oder zu restriktive robots.txt kann wichtige, verlinkte Inhalte versehentlich vom Crawling ausschliessen, was die Indexierung direkt schädigt.
- Rendering-Kosten durch JavaScript und CSS: Umfangreiche Skripte müssen von Google gerendert werden, was zusätzliche Rechenzeit und Crawl-Anfragen bindet.
Ein oft übersehener Punkt betrifft Cache-Busting-Parameter an statischen Ressourcen. Wird bei jedem Deployment ein neuer Query-Parameter an CSS- oder JS-Dateien angehängt, zwingt das Googlebot, diese Ressourcen erneut vollständig abzurufen, obwohl Google Ressourcen eigentlich bis zu 30 Tage cacht. Konsistente, versionsstabile URLs für wiederverwendete Assets verbessern die Cache-Effizienz spürbar und sparen damit Crawl-Kapazität für die eigentlichen Inhaltsseiten.
In der Praxis beobachten wir bei Kundenprojekten häufig eine Kombination aus mehreren dieser Muster gleichzeitig, etwa parametrisierte Filter-URLs kombiniert mit einer veralteten Sitemap, die längst entfernte Seiten noch immer listet.
Priorisierte Checkliste zur Crawl-Budget-Optimierung
Die folgende Reihenfolge hat sich bei mittelgrossen bis grossen Websites bewährt, weil sie zuerst die Massnahmen mit dem grössten Hebel und dem geringsten technischen Risiko umsetzt.
- Sitemap bereinigen: Entfernen Sie nicht-kanonische, redirecte oder 404-URLs aus der XML-Sitemap. Jede einzelne Sitemap-Datei darf laut Sitemaps maximal 50.000 URLs oder 50 Megabyte unkomprimiert enthalten; grössere Websites benötigen einen Sitemap-Index mit mehreren Teildateien.
- robots.txt gezielt einsetzen: Blockieren Sie ausschliesslich dauerhaft irrelevante Bereiche wie interne Suchergebnisse oder Admin-Pfade. Prüfen Sie vorher, ob dadurch verlinkte, wertvolle Inhalte versehentlich mitblockiert werden.
- Canonical, noindex und Statuscodes korrekt kombinieren: Nutzen Sie Canonical-Tags für inhaltsgleiche Varianten, noindex für Seiten, die existieren sollen, aber nicht in der Suche erscheinen sollen, und 404 oder 410 für endgültig entfernte Inhalte.
- Parameter-Handling serverseitig lösen: Bevorzugen Sie serverseitige Konsolidierung von Filter- und Sortierparametern gegenüber reiner robots.txt-Sperrung, da Letztere die Indexierung bereits bekannter URLs nicht rückgängig macht.
- Server-Antwortzeiten senken: Reduzieren Sie die TTFB durch Caching, ein Content Delivery Network und serverseitige Optimierung; aktivieren Sie gzip-Kompression für alle textbasierten Ressourcen, ein etablierter Standard zur Reduktion von Übertragungsgrössen.
- Statische Assets auslagern: Verlagern Sie Bilder, CSS und JavaScript auf einen separaten Host oder ein CDN. Das verschiebt einen Teil der Crawl-Last auf eine andere Host-Instanz und entlastet damit das Budget der Hauptdomain.
- Interne Verlinkung stärken: Bauen Sie Hub-Seiten und thematische Cluster, die wichtige Inhalte stärker verlinken und so den Crawl Demand für diese Seiten gezielt erhöhen.
- Deployment-Prozess automatisieren: Integrieren Sie automatische Sitemap-Updates und eine Release-Checkliste in Ihren Deployment-Workflow, damit neue oder entfernte Seiten konsistent nachgeführt werden.
Profi-Tipp: Prüfen Sie nach jeder grösseren Änderung an robots.txt zuerst in der Search Console, ob betroffene Seiten tatsächlich wie beabsichtigt behandelt werden, bevor Sie die nächste Massnahme umsetzen.
Ein technisches SEO-Audit hilft dabei, diese Schritte in der richtigen Reihenfolge und mit klaren Erfolgskriterien abzuarbeiten, statt punktuell einzelne Symptome zu beheben. Bei grösseren Relaunches lohnt sich zudem ein Blick auf eine strukturierte Release-Checkliste, damit Sitemaps und Redirects beim Go-Live nicht aus dem Blick geraten.
Monitoring und Erfolgs-KPIs nach der Umsetzung
Nach der Umsetzung zeigt sich der Erfolg nicht sofort, sondern über Wochen. Die wichtigsten Kennzahlen, die Sie regelmässig beobachten sollten:
- Anzahl gecrawlter URLs pro Tag, aus dem Crawl Stats Report.
- Durchschnittliche Serverantwortzeit im Zeitverlauf.
- Anteil von 4xx- und 5xx-Statuscodes an allen Crawl-Antworten.
- Time-to-Index für neu veröffentlichte Seiten.
Ein automatisiertes Logfile-Reporting, das wöchentlich die am häufigsten gecrawlten URL-Muster zusammenfasst, macht Abweichungen früh sichtbar, bevor sie sich in der Search Console niederschlagen. Steigt die Zahl der Crawl-Anfragen, während die Indexierungsrate stagniert oder sinkt, deutet das meist auf ein Qualitätsproblem hin, etwa dünnen Content, fehlende interne Verlinkung oder eine zu aggressive Konsolidierung über Canonicals.
Eine klare Regel hilft bei der Entscheidung über teure Infrastrukturmassnahmen: Ein Hosting-Upgrade lohnt sich erst, wenn die Analyse tatsächlich auf ein erreichtes Crawl Capacity Limit hindeutet, etwa durch konstant hohe Antwortzeiten trotz optimierter Software. Andernfalls verschwenden Sie Budget an der falschen Stelle, denn anhaltend langsame Serverantworten lösen eine Reduktion des Crawl Rate Limits aus, während kurzfristige Schwankungen normal sind und keine Panik rechtfertigen.
Unsere Erfahrungen und eine empfohlene Audit-Routine
Wir begleiten Unternehmen seit Jahren bei technischen SEO-Projekten, von der Diagnose bis zur Umsetzung in Produktivsystemen. Unser Schwerpunkt liegt auf massgeschneiderten Softwarelösungen und Webplattformen, kombiniert mit technischem SEO und gezieltem Einsatz von Automatisierung, was uns einen praxisnahen Blick auf Crawling-Probleme direkt im Code und in der Infrastruktur gibt.
Unsere empfohlene Audit-Routine folgt immer derselben Grundstruktur: zuerst Crawl Stats und Logfiles auswerten, dann Fehlerbilder nach Schweregrad sortieren, anschliessend Sitemap und robots.txt abgleichen, und erst danach serverseitige Massnahmen wie TTFB-Optimierung oder CDN-Einbindung angehen. Diese Reihenfolge verhindert, dass Infrastrukturinvestitionen getätigt werden, bevor einfachere strukturelle Probleme behoben sind.
— Outwork
Wann Crawl-Budget-Optimierung nicht oberste Priorität hat
Nicht jede Website muss sich intensiv mit Crawl-Budget beschäftigen. Eine kleine statische Seite mit wenigen hundert URLs erreicht praktisch nie die Grenzen des Crawl Capacity Limit, und aufwendiges Tuning verschwendet dort eher Zeit als dass es Nutzen stiftet.
Problematischer ist eine andere Fehleinschätzung: Crawl-Optimierung wird manchmal als Ersatz für fehlende inhaltliche Substanz missverstanden. Wenn Inhalte keine echte Relevanz oder Autorität in ihrem Themenfeld besitzen, ändert eine technisch perfekte Crawling-Struktur daran wenig, denn Google muss eine Seite erst für besuchenswert halten, bevor Crawl Demand überhaupt entsteht. Für solche Fälle empfiehlt sich ein schlankes Audit, das offensichtliche technische Blocker behebt, statt eine vollständige Remediation durchzuführen, deren Aufwand in keinem Verhältnis zum erwarteten Effekt steht.
Outwork-Leistungen für technisches SEO und Crawl-Budget-Optimierung
Crawl-Budget-Analysen gehören zu unserem Alltag in der technischen SEO-Beratung, da sie direkt mit Softwarearchitektur, Serverperformance und Content-Struktur zusammenhängen, drei relevante Bereiche in der technischen SEO-Beratung.

Konkret unterstützen wir bei:
- Technischem SEO-Audit inklusive Logfile-Analyse und Priorisierung der Befunde.
- Umsetzung von Sitemap-Struktur, robots.txt und Canonical-Logik im bestehenden System.
- Hosting- und Performance-Review zur Senkung der Serverantwortzeiten.
Wenn Sie wissen möchten, wo Ihre Website aktuell Crawl-Budget verliert, lohnt sich ein strukturiertes Audit als erster Schritt. Unsere SEO Agentur Schweiz liefert Ihnen dafür eine konkrete Bestandsaufnahme mit priorisierten Massnahmen, die sich direkt in Ihre Entwicklungs-Roadmap einplanen lassen.
FAQ
Wie kann ich meine Website für Google optimieren?
Eine saubere technische Grundlage, schnelle Serverantwortzeiten und eine klare interne Verlinkung bilden die Basis jeder Optimierung für Google. Prüfen Sie zunächst Crawling und Indexierung über die Search Console, bevor Sie an Inhalten oder Backlinks arbeiten, da technische Blocker sonst jede inhaltliche Verbesserung ausbremsen.
Was ist Crawlability?
Crawlability beschreibt, wie leicht Suchmaschinen-Bots wie Googlebot eine Website technisch erreichen und durchsuchen können. Hindernisse sind etwa blockierte Ressourcen, fehlerhafte Weiterleitungen oder eine unklare interne Verlinkung, die Seiten faktisch unauffindbar macht.
Ist SEO noch zeitgemäss?
Ja, Suchmaschinenoptimierung bleibt relevant, verändert sich aber durch KI-gestützte Suchfunktionen und Answer Engines spürbar. Technische Grundlagen wie Crawlbarkeit und Indexierung bleiben dabei Voraussetzung, unabhängig davon, ob klassische Suchergebnisse oder KI-generierte Antworten die Sichtbarkeit treiben.
Wie bekomme ich mehr Besucher auf meine Website?
Mehr Besucher entstehen meist aus einer Kombination aus technisch sauberer Indexierung, relevanten Inhalten für die Suchintention Ihrer Zielgruppe und gezielter interner Verlinkung auf Ihre wichtigsten Seiten. Ohne funktionierendes Crawling und Indexierung bleibt selbst guter Content für Google unsichtbar.
Wie spare ich Crawl-Budget konkret ein?
Entfernen oder konsolidieren Sie nicht-kanonische URLs wie Parameter-Varianten, beheben Sie Weiterleitungsketten und senken Sie die Serverantwortzeit, da langsame Antworten die Crawl-Frequenz direkt reduzieren. Eine bereinigte, aktuelle XML-Sitemap unterstützt diesen Prozess zusätzlich, indem sie Googlebot gezielt auf wertvolle Seiten lenkt.