Eine ereignisgesteuerte Architektur (EDA) ist ein Softwaredesign, bei dem Systeme über Zustandsänderungen, sogenannte Events, asynchron und entkoppelt kommunizieren, statt sich direkt per Anfrage anzusprechen. Der Nutzen liegt in höherer Reaktionsfähigkeit, unabhängiger Skalierbarkeit einzelner Komponenten und loser Kopplung zwischen Teams. Für einfache, transaktionale Systeme mit wenigen Abhängigkeiten lohnt sich der Mehraufwand meist nicht.
Kurz gesagt:
- Eine ereignisgesteuerte Architektur ist vor allem bei komplexen, verteilten Systemen mit mehreren Teams sinnvoll, da sie höhere Skalierbarkeit und Flexibilität ermöglicht.
- Für eine sichere Schema- und Vertrauensverwaltung empfiehlt sich eine zentrale Schema Registry mit klaren Kompatibilitätsrichtlinien, um Dateninkonsistenzen zu vermeiden.
- Bei der Wahl der Liefergarantie gilt in der Praxis meist At-least-once, da Exactly-once schwer umzusetzen ist und einen hohen Performance-Aufwand erfordert.
- Der schrittweise Übergang zu EDA durch Pattern wie Outbox oder Change Data Capture ist etabliert und verringert das Risiko bei Migrationen erheblich.
- Das gemeinsame Verständnis der relevanten Geschäftsereignisse in Workshops wie EventStorming bildet die Grundlage für eine erfolgreiche EDA-Einführung.
Inhaltsverzeichnis
- Definition, Grundprinzipien und Architekturübersicht
- Kernkomponenten und typische Muster im Überblick
- Event-Design und Schema-Contract-Management richtig umsetzen
- Verarbeitungsstile, Liefergarantien und Kafka-Konfiguration
- Event Sourcing und CQRS: Nutzen und Risiken abwägen
- EventStorming als Grundlage für gemeinsames Domänenverständnis
- Tooling und Plattformwahl für das Event-Streaming-Ökosystem
- Betrieb, Zuverlässigkeit und Observability im Event-System
- Migrationsstrategien: Refactoring statt riskanter Neubau
- Wirtschaftlicher Nutzen, Risiken und Entscheidungshilfe
- Was wir aus Kundenprojekten über EDA gelernt haben
- Wie wir die Einführung von EDA in Ihrem Unternehmen begleiten
- FAQ
- Quellen
Definition, Grundprinzipien und Architekturübersicht
Ein Event ist kein Befehl. Es beschreibt eine bereits eingetretene Zustandsänderung, etwa „Bestellung wurde aufgegeben“ oder „Zahlung wurde bestätigt“. Ein Command dagegen fordert eine Aktion ein und erwartet eine direkte Antwort. Diese Unterscheidung ist grundlegend: Wer Events wie Commands behandelt, baut heimlich wieder ein synchrones System.
EDA basiert auf Asynchronität und loser Kopplung. Producer veröffentlichen Events, ohne zu wissen, wer sie konsumiert, und Consumer reagieren, ohne den Ursprung kennen zu müssen. Dieses Event-First-Denken verschiebt den Entwurf: Statt „Welche Services rufen welche APIs auf?“ fragt man „Welche Zustandsänderungen sind für das Geschäft relevant, und wer braucht davon Kenntnis?“.
Im Vergleich zur klassischen anfragegesteuerten Architektur, bei der ein Client aktiv eine Antwort erwartet und der Aufrufer blockiert bleibt, kehrt EDA die Richtung um: Der Sender weiss nicht, wer reagiert, und muss nicht warten. Das Azure Architecture Center beschreibt diesen Stil als eigenständiges Muster mit eigenen Betriebsanforderungen, nicht als blosse Variante der Microservices-Architektur. Mehr zur Abgrenzung zwischen monolithischen und verteilten Designs findet sich in unserem Beitrag zu Microservices und Monolith.
Die wichtigsten Grundprinzipien im Überblick:
- Events sind unveränderliche Fakten der Vergangenheit, keine Handlungsaufforderungen.
- Producer und Consumer kennen sich nicht und sind zeitlich entkoppelt.
- Die Kommunikation läuft über einen Vermittler, nie direkt zwischen den Diensten.
- Jede Komponente kann unabhängig skalieren, ausfallen oder ersetzt werden.
Wer diese Prinzipien ernst nimmt, merkt schnell: EDA ist weniger eine Technologieentscheidung als eine Denkweise, die sich erst mit der passenden Systemlandschaft auszahlt. Unser Artikel zur ERP-Entwicklung zeigt, wie sich solche Architekturentscheidungen konkret auf gewachsene Unternehmenssysteme auswirken.
Kernkomponenten und typische Muster im Überblick
Jede ereignisgesteuerte Architektur braucht mindestens drei Rollen: einen Producer, der Events erzeugt, einen Broker beziehungsweise Event-Bus, der sie verteilt, und einen Consumer, der darauf reagiert. Dazu kommt häufig eine Schema Registry, die festlegt, wie ein Event aufgebaut sein muss, sowie eine Stream-Processing-Schicht für komplexere Transformationen und Aggregationen in Echtzeit.
Der Broker ist das Herzstück. Apache Kafka hat sich als De-facto-Standard für hochvolumige Event-Streaming-Szenarien etabliert, weil er Events dauerhaft persistiert und mehrere Consumer unabhängig voneinander lesen lässt. Andere Broker wie RabbitMQ oder cloud-native Dienste eignen sich eher für klassisches Messaging mit geringerer Durchsatzanforderung.
Innerhalb von EDA haben sich mehrere wiederkehrende Muster herausgebildet:
- Publish/Subscribe: Ein Producer veröffentlicht ein Event an ein Topic, beliebig viele Consumer abonnieren es unabhängig voneinander.
- Event Notification: Ein schlankes Event informiert nur über das „Was“, der Consumer holt Details bei Bedarf über eine eigene Anfrage nach.
- Event-Carried State Transfer: Das Event trägt den vollständigen relevanten Zustand mit sich, sodass der Consumer keine Rückfrage braucht, dafür aber grössere Nachrichten verarbeitet.
- Event Streaming: Events werden als fortlaufender, geordneter Strom behandelt, den mehrere Anwendungen in Echtzeit auswerten oder transformieren.
Die Wahl zwischen diesen Mustern hängt stark vom Kopplungsgrad ab, den man bereit ist einzugehen. Event-Carried State Transfer reduziert die Zahl der Rückfragen, erhöht aber die Nachrichtengrösse und die Verantwortung des Producers, Daten korrekt und aktuell zu halten. Event Notification bleibt schlank, erzeugt dafür mehr Netzwerkverkehr durch Nachfragen.
Bei der Diagrammerstellung lohnt es sich, Verantwortlichkeiten klar zu trennen: Wer besitzt das Schema eines Events, wer betreibt den Broker, und wer ist für die Wiederverarbeitung bei Fehlern zuständig? Diese Fragen werden in der Praxis oft erst während des Betriebs beantwortet, was zu Reibungsverlusten führt. Ein Verantwortlichkeitsdiagramm pro Event-Typ, nicht nur pro Service, schafft hier früh Klarheit. Wie sich solche verteilten Verantwortlichkeiten technisch über APIs verbinden lassen, zeigt unser Beitrag zu Microservices versus Monolith.
Event-Design und Schema-Contract-Management richtig umsetzen
Ein Event ohne verbindlichen Vertrag ist ein Risiko, das erst beim ersten inkompatiblen Deployment sichtbar wird. Die CloudEvents-Spezifikation löst einen Teil dieses Problems, indem sie ein gemeinsames Metadatenformat definiert, das Herkunft, Typ und Zeitstempel eines Events unabhängig vom konkreten Broker beschreibt. Das erhöht die Interoperabilität zwischen Systemen, die sonst jeweils eigene Konventionen entwickeln würden.
Für die eigentliche Nutzlast eines Events stehen mehrere Serialisierungsformate zur Wahl, jedes mit eigenen Abwägungen:
- Avro: Kompakt und schnell, mit eingebauter Schema-Evolution über eine Registry, aber weniger menschenlesbar.
- Protobuf: Ähnlich kompakt, sprachunabhängig und weit verbreitet in Microservices-Umgebungen, erfordert aber generierten Code.
- JSON Schema: Menschenlesbar und einfach zu debuggen, dafür grösser im Durchsatz und schwächer in der strikten Typisierung.
Eine Schema Registry verwaltet Versionen zentral und verhindert, dass ein Producer ein Event veröffentlicht, das kein Consumer mehr lesen kann. Entscheidend ist die Kompatibilitätsrichtlinie: Rückwärtskompatibilität erlaubt neuen Consumern, alte Events zu lesen, Vorwärtskompatibilität das Gegenteil, und volle Kompatibilität verlangt beides gleichzeitig. Die meisten Teams fahren mit einer strikten Rückwärtskompatibilitätsregel am sichersten, weil sie Producer-Updates nicht an jeden Consumer-Rollout koppelt.
Der Deployment-Prozess für Schemaänderungen sollte denselben Review-Disziplinen folgen wie API-Änderungen: ein Pull-Request pro Schemaversion, automatisierte Kompatibilitätsprüfung in der CI-Pipeline, und ein Deprecation-Zeitraum für alte Feldnamen statt sofortigem Löschen. Wer neue Pflichtfelder einführt, ohne Standardwerte zu definieren, bricht fast immer bestehende Consumer.
Profi-Tipp: Versionieren Sie Events nicht nur im Schema, sondern auch im Topic-Namen oder Header, damit Sie alte und neue Konsumenten parallel betreiben können, ohne einen harten Cutover zu riskieren.
Wer Eigenentwicklungen plant, bei denen Schemaverträge über mehrere Teams hinweg gelten, profitiert von einer dedizierten Governance-Rolle, die Breaking Changes vor dem Merge blockiert statt im Nachgang zu reparieren.
Verarbeitungsstile, Liefergarantien und Kafka-Konfiguration
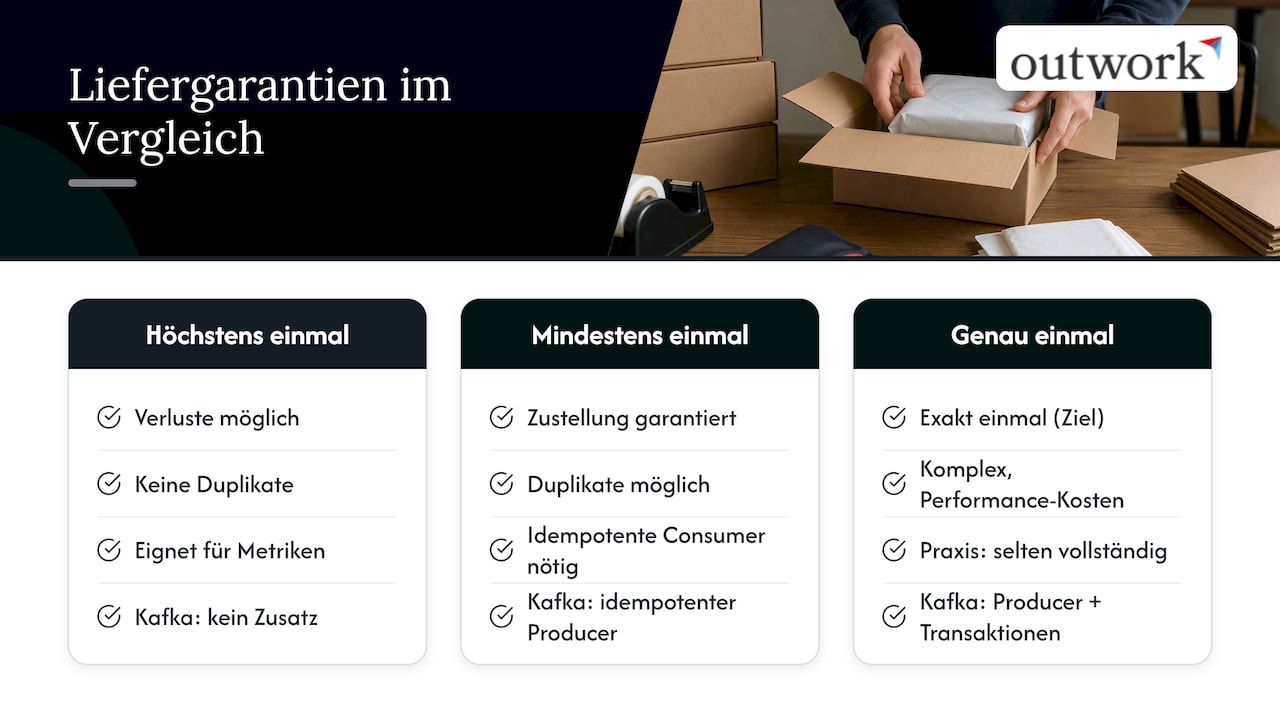
Die Liefergarantie eines Event-Systems entscheidet darüber, ob ein Event verloren gehen, doppelt verarbeitet oder exakt einmal zugestellt wird, und jede dieser drei Optionen hat Konsequenzen für die Anwendungslogik. At-most-once akzeptiert Datenverlust bei Fehlern und eignet sich nur, wo das tolerierbar ist, etwa bei reinen Metrikdaten. At-least-once garantiert Zustellung, kann Events aber mehrfach liefern, was idempotente Verarbeitung auf Consumer-Seite voraussetzt. Exactly-once ist das anspruchsvollste Ziel und in der Praxis selten vollständig erreichbar, ohne Kompromisse an anderer Stelle einzugehen.
In Apache Kafka lässt sich die Zuverlässigkeit über zwei Mechanismen deutlich verbessern. Der idempotente Producer-Modus verhindert Duplikate, die durch Netzwerk-Retries entstehen, indem jede Nachricht eine eindeutige Sequenznummer erhält. Für atomare Schreibvorgänge über mehrere Partitionen oder Topics hinweg ist zusätzlich der transaktionale Modus nötig, der sicherstellt, dass entweder alle oder keine der zusammengehörigen Nachrichten sichtbar werden. Laut Conduktor erfordert echtes Exactly-once-Verhalten in verteilten Systemen genau diese Kombination, bringt aber messbare Performance-Kosten mit sich, weil Transaktionen zusätzliche Koordination verlangen.
Idempotente Konsumenten sind in der Praxis oft der pragmatischere Weg als die volle Transaktionsgarantie, weil sie weniger Koordinationsaufwand erzeugen und sich leichter horizontal skalieren lassen.
Auf der Consumer-Seite bestimmen Consumer Groups die Lastverteilung: Jede Partition eines Topics wird genau einem Consumer innerhalb einer Gruppe zugeordnet, sodass Parallelität direkt von der Partitionsanzahl abhängt. Fällt ein Consumer aus oder wird eine neue Instanz hinzugefügt, löst das ein Rebalancing aus, bei dem Partitionen neu verteilt werden, was kurzfristig zu Verarbeitungspausen führt.
Die Poll-Loop-Semantik ist dabei eine häufig unterschätzte Fehlerquelle. Ein Consumer muss regelmässig pollen, um als „lebendig“ zu gelten; überschreitet er max.poll.interval.ms, wird er aus der Gruppe entfernt und seine Partitionen neu verteilt, selbst wenn der Prozess technisch noch läuft. Wer rechenintensive Verarbeitung direkt im Poll-Thread ausführt, riskiert genau dieses Problem. Die gängige Lösung ist, die eigentliche Verarbeitung an einen separaten Thread-Pool auszulagern und den Poll-Loop schlank zu halten, auch wenn das zusätzliche Komplexität beim Offset-Management mit sich bringt.
Event Sourcing und CQRS: Nutzen und Risiken abwägen
Event Sourcing speichert nicht den aktuellen Zustand einer Entität, sondern die vollständige Folge aller Events, die zu diesem Zustand geführt haben. Der Event Store wird damit zur einzigen Quelle der Wahrheit, aus der sich jeder frühere Zustand durch Replay rekonstruieren lässt. Das ermöglicht lückenlose Audit-Trails und die Möglichkeit, Fehler durch erneutes Abspielen der Historie zu analysieren oder zu korrigieren.
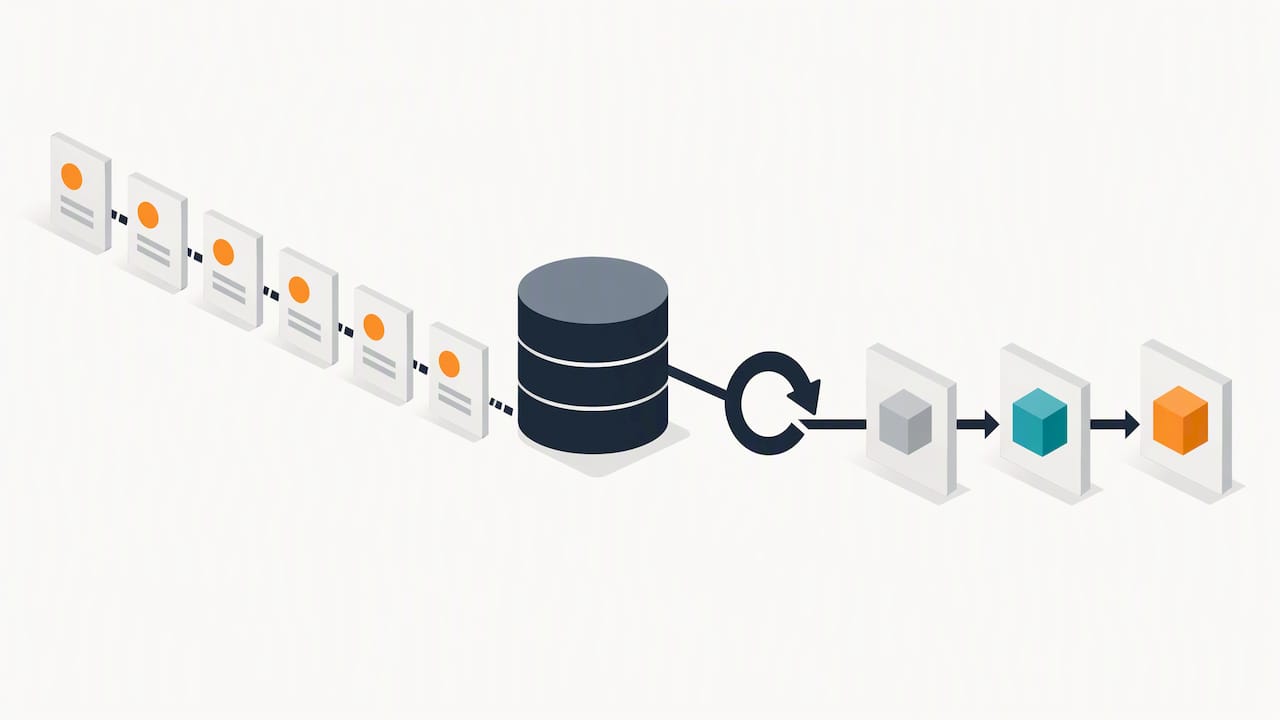
CQRS, die Trennung von Schreib- und Lesepfad, ergänzt dieses Muster häufig, ist aber kein Pflichtbestandteil von Event Sourcing. Schreibvorgänge validieren Commands und erzeugen Events, während separate, oft stark denormalisierte Lesemodelle für schnelle Abfragen aus diesen Events aufgebaut werden. Martin Fowler warnt ausdrücklich davor, beide Muster voreilig einzusetzen: Sie bringen erhebliche Komplexität mit sich und eignen sich nur für Domänen mit echtem Bedarf an Historie, Nachvollziehbarkeit oder stark unterschiedlichen Lese- und Schreiblasten.
Das grösste praktische Risiko ist Eventual Consistency: Zwischen dem Schreiben eines Events und seiner Sichtbarkeit im Lesemodell liegt eine Verzögerung, die Anwendungslogik und Nutzeroberfläche berücksichtigen müssen. Auch Fowlers CQRS-Artikel betont, dass dieser Mehraufwand nur in spezifischen Domänenanforderungen gerechtfertigt ist und bei falscher Anwendung die Wartungskosten langfristig erhöht.
Eine kurze Checkliste hilft bei der Entscheidung:
- Brauchen wir eine vollständige, unveränderliche Historie für Audit- oder Compliance-Zwecke?
- Unterscheiden sich Lese- und Schreiblast so stark, dass getrennte Modelle einen echten Vorteil bringen?
- Ist das Team bereit, Eventual Consistency in der Benutzerführung sichtbar zu machen?
- Gibt es im Fehlerfall einen klaren Plan für Replay und Zustandsreparatur?
- Übersteigt der erwartete Nutzen den zusätzlichen operativen Aufwand für Event Store und Projektionen?
Nur wenn mehrere dieser Fragen klar mit Ja beantwortet werden, rechtfertigt sich der Einsatz dieser beiden Muster gegenüber einem einfacheren, klassischen Datenmodell.
EventStorming als Grundlage für gemeinsames Domänenverständnis
Bevor ein einziges Event-Schema entworfen wird, lohnt sich ein Schritt zurück: Wer im Unternehmen weiss eigentlich, welche Zustandsänderungen geschäftlich relevant sind? EventStorming ist eine Workshop-Methode, die genau diese Frage beantwortet, indem Fachleute aus Business und IT gemeinsam an einer grossen Papierwand alle relevanten Geschäftsereignisse chronologisch mit orangen Klebezetteln festhalten. Laut Open-line entsteht dabei ein gemeinsames Domänenverständnis, das Grenzen für Bounded Contexts sichtbar macht, lange bevor Code geschrieben wird.
Der Ablauf folgt typischerweise mehreren Phasen: Zunächst sammeln alle Beteiligten chaotisch jedes denkbare Event, danach wird die Chronologie sortiert, Unklarheiten werden markiert, und schliesslich werden Commands, Aktoren und Aggregate ergänzt. Entscheidend ist die Moderation: Eine Person muss den Workshop lenken, ohne inhaltlich zu dominieren, und Fachbereichsvertreter müssen tatsächlich im Raum sein, nicht nur IT-Architekten unter sich.
Typische Fallen sind ein zu technischer Fokus von Beginn an, der Fachleute aus dem Gespräch drängt, sowie Workshops ohne klare Nachbereitung, deren Ergebnisse danach in einer Schublade verschwinden. Auch laut dem Open Practice Library hängt der Erfolg von EDA-Projekten oft stärker vom gemeinsamen Domänenverständnis ab als von der gewählten Technologie.
In unseren eigenen Projekten nutzen wir EventStorming-Ergebnisse direkt als Grundlage für die technische Event-Modellierung: Die am Whiteboard identifizierten Geschäftsereignisse werden zu konkreten Event-Schemas, die am Whiteboard sichtbar gewordenen Bounded Contexts zu Serviceschnitten, und die Diskussionen über unklare Zuständigkeiten zu den ersten Punkten der MVP-Planung.
Profi-Tipp: Fotografieren Sie die Workshop-Wand nicht nur als Dokumentation, sondern übertragen Sie sie innerhalb von 48 Stunden in ein digitales Format, solange sich alle Beteiligten noch an die Begründung hinter jeder Entscheidung erinnern.
Tooling und Plattformwahl für das Event-Streaming-Ökosystem
Die technische Plattformwahl entscheidet darüber, wie viel Betriebsaufwand ein Team dauerhaft trägt. Apache Kafka bildet meist den Kern, ergänzt durch Kafka Connect für Anbindungen an Datenbanken und externe Systeme sowie Kafka Streams oder Apache Flink für Echtzeit-Transformationen direkt auf dem Event-Strom. Eine Schema Registry rundet das Ökosystem ab, indem sie Verträge zentral verwaltet. Ein Fachkurs der BFH beschreibt diese Kombination als mittlerweile etabliertes Muster für unternehmensweites Event-Streaming.
Zur Auswahl stehen grob drei Betriebsmodelle:
- Selbstbetrieb: Volle Kontrolle über Konfiguration und Skalierung, dafür eigenes Team für Patching, Monitoring und Kapazitätsplanung nötig.
- Managed Services: Cloud-Anbieter übernehmen Betrieb und Skalierung gegen SLA, reduzieren aber Kontrolle über Low-Level-Tuning.
- Hybrid-Ansätze: Kritische Topics selbst betrieben, weniger kritische Workloads bei einem Managed-Service, mit entsprechendem Integrationsaufwand.
Die Entscheidung hängt stark vom verfügbaren Betriebsteam ab. Ein Unternehmen ohne dedizierte Plattform-Ingenieure fährt mit einem Managed Service meist sicherer, auch wenn die laufenden Kosten pro Durchsatzeinheit höher liegen als beim Eigenbetrieb auf eigener Infrastruktur. Umgekehrt lohnt sich Eigenbetrieb erst ab einer Grössenordnung, bei der die Lizenz- oder Nutzungskosten des Managed Services den Personalaufwand für den Eigenbetrieb klar übersteigen.
Die Integration mit bestehenden Cloud-Diensten und Datenplattformen ist meist der Punkt, an dem Projekte entweder reibungslos verlaufen oder ins Stocken geraten. Wer bereits auf einer Cloud-Plattform mit nativen Event-Diensten aufsetzt, spart Integrationsaufwand gegenüber dem Betrieb einer komplett eigenständigen Kafka-Landschaft parallel dazu. Wie sich solche Entscheidungen auf angebundene KI-Systeme auswirken, zeigt unser technischer Leitfaden zur RAG-Architektur, der ähnliche Integrationsfragen für datengetriebene Anwendungen behandelt.
Betrieb, Zuverlässigkeit und Observability im Event-System
Ein Event-System, das niemand überwachen kann, ist auf Dauer ein Risiko statt eines Vorteils. Observability beginnt mit drei Grundgrössen: Durchsatz pro Topic, Consumer-Lag als Mass dafür, wie weit ein Consumer hinter dem aktuellen Stand zurückliegt, und Fehlerraten pro Event-Typ. Verteiltes Tracing über Event-Grenzen hinweg macht sichtbar, welcher Schritt in einer mehrstufigen Verarbeitungskette ein Problem verursacht, was bei rein asynchronen Systemen ohne klaren Aufruf-Stack sonst kaum nachvollziehbar ist.
Consumer-Lag ist die zentrale Betriebsmetrik für Event-Streaming: Steigt der Lag kontinuierlich, verarbeitet ein Consumer dauerhaft langsamer, als neue Events eintreffen, was früher oder später zu Datenstau führt, wenn nicht gegengesteuert wird.
Für den Fehlerfall braucht jedes produktive System eine klare Strategie:
- Dead-Letter-Queues fangen Nachrichten ab, die wiederholt nicht verarbeitet werden können, statt die gesamte Pipeline zu blockieren.
- Retry-Strategien mit exponentiellem Backoff verhindern, dass ein kurzzeitiger Ausfall sofort zur Dauerlast auf nachgelagerte Systeme wird.
- Backpressure und Throttling drosseln Producer, wenn Consumer nicht mithalten, statt Puffer unkontrolliert anwachsen zu lassen.
- Reconciliation-Prozesse vergleichen periodisch Zielsysteme mit der Event-Historie, um stille Inkonsistenzen aufzudecken.
Testing-Strategien müssen über klassische Unit-Tests hinausgehen. Integrationstests mit einem echten oder eingebetteten Broker decken Serialisierungsfehler auf, die reine Mock-Tests übersehen. Chaos-Testing, bei dem gezielt Broker-Knoten oder Netzwerkverbindungen während des Betriebs gekappt werden, zeigt, ob Rebalancing und Retry-Logik tatsächlich wie erwartet greifen. Ohne diese Disziplin bleiben viele Fehlerpfade bis zum ersten echten Ausfall ungetestet, und genau dann zeigt sich, ob die Dead-Letter-Queue tatsächlich konfiguriert war oder nur auf dem Papier existierte.
Migrationsstrategien: Refactoring statt riskanter Neubau
Ein bestehendes System komplett neu zu schreiben, um EDA einzuführen, ist fast immer der riskantere Weg gegenüber einem schrittweisen Umbau. Das Strangler Pattern bietet die praxisnähere Alternative: Neue Funktionalität wird event-gesteuert implementiert und schrittweise um das bestehende System herum gelegt, bis die alte Logik Stück für Stück abgelöst werden kann, ohne einen harten Cutover-Termin zu riskieren.
Die grösste Falle bei dieser Seite-an-Seite-Integration ist Dual-Write: Eine Anwendung schreibt gleichzeitig in die klassische Datenbank und veröffentlicht ein Event, und bei einem Absturz zwischen beiden Schritten driften Datenbank und Event-Strom unbemerkt auseinander. Zwei robuste Muster vermeiden dieses Problem. Das Outbox Pattern schreibt das Event innerhalb derselben Datenbanktransaktion wie die fachliche Änderung in eine lokale Tabelle und veröffentlicht es erst danach asynchron, wie Martin Fowlers Beschreibung von Event-Mustern nahelegt. Change Data Capture liest Änderungen direkt aus dem Transaktionslog der Datenbank und erzeugt daraus Events, ganz ohne dass die Anwendung selbst etwas veröffentlichen muss.
Eine realistische Roadmap verläuft in Phasen:
- Pilotbereich identifizieren: Einen klar abgegrenzten, risikoarmen Geschäftsprozess als ersten Kandidaten wählen, nie das Kernsystem zuerst.
- Event-Schema und Broker aufsetzen: Schema Registry, Kompatibilitätsrichtlinien und Observability von Anfang an mitplanen, nicht nachträglich ergänzen.
- Outbox oder CDC parallel zum Altsystem betreiben: Beide Pfade eine Zeit lang gegeneinander validieren, bevor das alte System abgeschaltet wird.
- Schrittweise weitere Domänen migrieren: Erfahrungen aus dem Pilotbereich systematisch in die nächsten Bereiche übertragen.
Diese Phasen erstrecken sich in der Praxis typischerweise über mehrere Quartale pro Domäne, abhängig von der Komplexität der Altsysteme und der Reife des Teams im Umgang mit asynchronen Mustern.
Profi-Tipp: Betreiben Sie Outbox oder CDC mindestens einen vollen Geschäftszyklus parallel zum Altsystem, bevor Sie dessen Schreibpfad endgültig abschalten, damit Diskrepanzen unter realer Last sichtbar werden.
Wie sich solche Migrationsschritte organisatorisch absichern lassen, insbesondere bei der Akzeptanz durch Fachbereiche, beschreibt unser Beitrag zum Change Management in IT-Projekten.
Wirtschaftlicher Nutzen, Risiken und Entscheidungshilfe
Der wirtschaftliche Nutzen von EDA zeigt sich selten sofort in der Bilanz, sondern in operativen Kennzahlen: kürzere Latenz zwischen Geschäftsereignis und Reaktion, höherer Durchsatz bei Lastspitzen, kürzere mittlere Reparaturzeit durch bessere Isolation von Fehlern, und schnellere Time-to-Market, weil Teams neue Consumer anschliessen können, ohne bestehende Producer anzufassen. Unser Beitrag zu individueller Softwareentwicklung zeigt, wie sich solche strukturellen Investitionen über mehrere Jahre amortisieren können.
Diesem Nutzen stehen reale Risiken gegenüber:
- Komplexität: Verteilte Systeme sind grundsätzlich schwerer zu debuggen als monolithische Aufrufketten.
- Betriebskosten: Broker, Schema Registry und Observability-Tooling verursachen laufenden Aufwand, der eingeplant werden muss.
- Governance-Lücken: Ohne klare Schema-Eigentümerschaft entstehen Breaking Changes, die mehrere Teams gleichzeitig treffen.
Eine kompakte Entscheidungshilfe für Verantwortliche:
| Frage | Worauf es ankommt |
|---|---|
| Wie viele unabhängige Teams müssen auf dieselben Daten reagieren? | Je mehr, desto stärker der Nutzen von Entkopplung |
| Wie kritisch ist Nachvollziehbarkeit jeder Zustandsänderung? | Hoher Bedarf spricht für Event Sourcing |
| Ist ein Betriebsteam für Broker und Registry vorhanden? | Fehlt es, eher Managed Service erwägen |
| Toleriert das Geschäft Eventual Consistency? | Nein, dann CQRS kritisch prüfen |
| Wie reif ist die bestehende Systemlandschaft für Migration? | Bestimmt Tempo der Einführung |
| Existiert bereits ein Schema-Governance-Prozess? | Fehlt er, zuerst aufbauen |
| Ist der Business Case über mehrere Quartale tragfähig? | EDA zahlt sich selten kurzfristig aus |
Was wir aus Kundenprojekten über EDA gelernt haben
In Projekten zeigt sich immer wieder dasselbe Muster: Die technische Einführung von Kafka oder einer Schema Registry gelingt meist schneller, als Teams erwarten. Die eigentliche Hürde liegt im organisatorischen Umdenken, das Event-First-Denken verlangt. Fachbereiche, die jahrelang in Anfrage-Antwort-Kategorien gedacht haben, brauchen Zeit, um Geschäftsereignisse als eigenständige, wertvolle Artefakte zu begreifen, statt als Nebenprodukt einer Datenbankoperation.
Unsere Projektpraxis kombiniert deshalb bewusst drei Ebenen: einen EventStorming-Workshop zur Klärung der Domänensprache, eine technische Architekturberatung zur Auswahl von Broker, Schema-Strategie und Liefergarantien, und schliesslich die konkrete Implementierung inklusive Observability. Wird eine dieser Ebenen übersprungen, zeigt sich das fast immer später als teurer Nachbesserungsbedarf, meist in Form von inkompatiblen Schemas oder unklaren Verantwortlichkeiten zwischen Teams.
Der grösste Fehler, den wir wiederholt beobachten, ist der Versuch, EDA flächendeckend einzuführen, statt mit einem klar abgegrenzten, geschäftlich relevanten Pilotbereich zu beginnen und von dort aus zu lernen.
Wie wir die Einführung von EDA in Ihrem Unternehmen begleiten
Eine ereignisgesteuerte Architektur lohnt sich nur, wenn Workshop, Architektur und Implementierung aus einer Hand zusammenpassen, statt in drei getrennten Projekten mit unterschiedlichen Annahmen zu enden. Genau das lässt sich abbilden: von der EventStorming-Moderation über die Auswahl von Broker, Schema-Strategie und Liefergarantien bis zum Aufbau der produktiven Infrastruktur inklusive Observability.

Je nach Ausgangslage bieten sich unterschiedliche Einstiege an. Für Unternehmen, die EDA zunächst in einem begrenzten Bereich testen wollen, eignet sich ein kompakter Proof of Concept mit klar definiertem Pilotprozess. Für Unternehmen, die bereits einen konkreten Migrationsbedarf haben, kann ein vollständiges Projekt über mehrere Phasen geplant werden. Wo laufender Betrieb und Weiterentwicklung gefragt sind, bieten sich Retainer-Modelle an, welche Architekturberatung, Entwicklung und Support bündeln.
Leistungen zur Softwareentwicklung können diesen gesamten Weg abdecken, von der ersten Architekturberatung bis zum produktiven Betrieb. Wer EDA als Teil einer grösseren SaaS-Plattform plant, findet in der SaaS-Entwicklung einen passenden Einstiegspunkt für ein Erstgespräch.
FAQ
Was unterscheidet ereignisgesteuerte Architektur von Microservices?
Microservices beschreiben, wie Funktionalität in unabhängige Dienste aufgeteilt wird, während ereignisgesteuerte Architektur beschreibt, wie diese Dienste kommunizieren. Microservices können synchron über APIs oder asynchron über Events kommunizieren, EDA ist also ein möglicher, aber nicht zwingender Kommunikationsstil innerhalb einer Microservices-Landschaft.
Wann lohnt sich Event Sourcing für ein Unternehmen?
Event Sourcing lohnt sich vor allem dort, wo vollständige Nachvollziehbarkeit jeder Zustandsänderung geschäftlich notwendig ist, etwa bei Audit-Anforderungen oder komplexen Workflows mit Korrekturbedarf. Martin Fowler warnt davor, das Muster einzusetzen, wenn dieser Bedarf nicht klar besteht, da es erhebliche zusätzliche Komplexität mitbringt.
Welche Liefergarantie sollte ich in Kafka wählen?
Die Wahl hängt vom Anwendungsfall ab: At-least-once mit idempotenten Konsumenten ist für die meisten Geschäftsprozesse ausreichend und einfacher zu betreiben als volle Exactly-once-Semantik. Für atomare, partitionsübergreifende Schreibvorgänge ist laut Conduktor der transaktionale Producer-Modus notwendig, bringt aber zusätzlichen Koordinationsaufwand mit sich.
Was ist der Unterschied zwischen Refactoring und einem kompletten Rewrite bei der EDA-Einführung?
Refactoring führt EDA schrittweise über Muster wie das Strangler Pattern ein, wobei das Altsystem so lange weiterläuft, bis neue, event-gesteuerte Komponenten es Stück für Stück ersetzen. Ein kompletter Rewrite ersetzt das System auf einmal, was deutlich höheres Risiko birgt, da Fehler erst beim grossen Umschalttermin sichtbar werden statt schrittweise im Betrieb.
Welche Rolle spielt EventStorming bei der Einführung von EDA?
EventStorming ist ein Workshop-Format, in dem Fachbereiche und IT gemeinsam die relevanten Geschäftsereignisse einer Domäne erarbeiten, bevor technische Schemas entworfen werden. Laut Open-line.ch entsteht dabei ein gemeinsames Domänenverständnis, das spätere Fehlentwürfe in Event-Schemas und Serviceschnitten deutlich reduziert.
Quellen
- CloudEvents Specification
- Exactly-Once Semantics In Kafka — Conduktor Glossary
- KafkaConsumer — Apache Kafka Documentation
- Open-line
- Event Sourcing — Martin Fowler