Strukturierte Daten (Schema.org) sind maschinenlesbare Markups, die Suchmaschinen und KI erlauben, Ihre Inhalte als Rich Results und zitierfähige Quellen zu erkennen. Der direkte Nutzen liegt in besserer Darstellung in den Suchergebnissen und einer höheren Auffindbarkeit durch KI-Systeme. Für die technische Umsetzung empfiehlt sich in den meisten Fällen JSON-LD als Format der Wahl.
Kurz gesagt:
- Für Produktseiten, Artikel, Veranstaltungen und Unternehmensprofile ist vollständiges und korrektes Schema.org-Markup essenziell, um Rich Results und KI-Auffindbarkeit zu fördern.
- JSON-LD ist das bevorzugte Format, da es leichter zu pflegen und in bestehende Systeme zu integrieren ist, während Microdata und RDFa seltener genutzt werden.
- Die Wirkung von strukturierten Daten auf die Platzierung ist nicht garantiert, sondern hängt stark von Datenqualität und Vollständigkeit ab.
- Technische und redaktionelle Integration im Content-Workflow ist notwendig, um Konsistenz und Aktualität bei Markup zu gewährleisten.
- Regelmäßige Validierung und Monitoring sind unerlässlich, um Fehler zu vermeiden und die Wirkung der strukturierten Daten optimal zu nutzen.
Inhaltsverzeichnis
- Was ist Schema.org? Grundlagen, Vokabular und Datenmodell
- Wie strukturierte Daten SEO, Rich Snippets und KI-Sichtbarkeit beeinflussen
- Formate und relevante Schema-Typen: JSON-LD, Microdata und RDFa
- Praxis-Implementierung: Schritt-für-Schritt-Anleitung mit Beispiel-JSON-LD
- Testen, validieren und überwachen: empfohlene Tools und Prüfablauf
- Best Practices und häufige Fehler vermeiden
- Praktische Tools, Plugins und Developer-Ressourcen
- Outwork-Perspektive: Vorgehen, KPIs und messbarer Nutzen
- Warum die meisten Teams strukturierte Daten falsch priorisieren
- Implementierung und Optimierung strukturierter Daten als Service
- FAQ
- Quellen
Was ist Schema.org? Grundlagen, Vokabular und Datenmodell
Schema.org ist ein gemeinsames Vokabular, das Suchmaschinen, Entwickler und zunehmend auch KI-Systeme nutzen, um Inhalte strukturiert zu beschreiben. Das Vokabular ist umfangreich: Es umfasst rund 826 Typen und 1.540 Eigenschaften, die laufend erweitert werden. Jeder Typ wie Article, Product oder Organization trägt bestimmte Properties, mit denen sich Eigenschaften wie Name, Preis oder Veröffentlichungsdatum maschinenlesbar hinterlegen lassen.
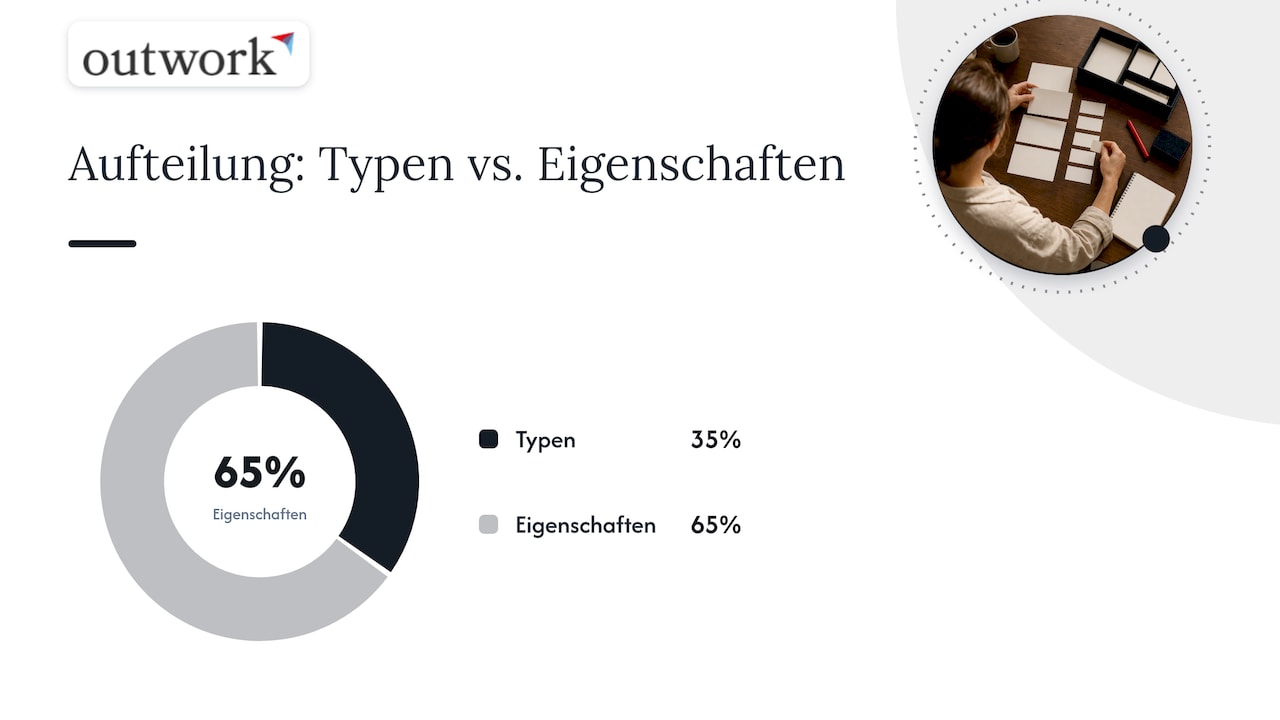
Das Datenmodell dahinter stammt ursprünglich aus dem RDF-Umfeld und erlaubt Mehrfachvererbung: Ein Typ wie LocalBusiness erbt beispielsweise Eigenschaften von Organization und Place gleichzeitig. Über die Konzepte domainIncludes und rangeIncludes legt Schema.org fest, welche Eigenschaften zu welchem Typ gehören und welche Werte dort erlaubt sind. Wer tiefer einsteigen will, findet das vollständige Datenmodell in dem Schema.org Dokumentation.
Nicht jede Seite profitiert gleich stark von Markup. Besonders lohnend ist es für:
- Produktseiten mit Preisen, Verfügbarkeit und Bewertungen
- Artikel und Blogbeiträge mit Autor, Datum und Hauptbild
- Veranstaltungsseiten mit Ort, Datum und Ticketinformationen
- Unternehmensseiten mit Adresse, Öffnungszeiten und Kontaktdaten
- FAQ- und How-to-Inhalte mit klar abgrenzbaren Frage-Antwort-Paaren
Wer diese Seitentypen im Portfolio hat, sollte Schema.org nicht als optionales Extra, sondern als festen Bestandteil der technischen SEO-Architektur behandeln.
Wie strukturierte Daten SEO, Rich Snippets und KI-Sichtbarkeit beeinflussen
Strukturierte Daten wirken auf zwei Ebenen, die oft vermischt werden. Zum einen ermöglichen sie Google Rich Results: optisch angereicherte Suchergebnisse mit Sternebewertungen, Preisen oder Veranstaltungsdaten. Zum anderen verbessern sie die generelle Maschinenlesbarkeit für KI-Agenten und Answer Engines, die Inhalte für Zusammenfassungen oder Zitate heranziehen. Beide Effekte überlappen sich, sind aber nicht identisch.
Die konkreten Vorteile sind vielfältig:
- Rich Snippets erhöhen die visuelle Präsenz in den Suchergebnissen
- Knowledge Signals stärken die Einordnung von Entitäten wie Personen, Organisationen oder Produkten
- Saubere Entity-Daten unterstützen Answer Engine Optimization und Generative Engine Optimization, da KI-Systeme klar definierte Entitäten leichter zitieren
Schema.org stellt rund 826 Typen und 1.540 Properties bereit, die als gemeinsames Vokabular für diese Signale dienen, was zeigt, wie granular sich Inhalte beschreiben lassen.
Zugleich gilt: Markup garantiert keine bessere Platzierung. Google selbst entscheidet, ob und wie ein Rich Result angezeigt wird, selbst wenn das Markup technisch korrekt ist. Die Qualität der Darstellung hängt stark von Vollständigkeit und Korrektheit der Daten ab: Fehlende Pflichtfelder oder widersprüchliche Angaben verringern die Chance auf eine Anzeige deutlich. Wer strukturierte Daten als Ranking-Hack verkauft, verspricht etwas, das die Technik nicht hält. Realistisch betrachtet ist Schema.org ein Verständigungswerkzeug zwischen Website und Maschine, kein Rankingfaktor im klassischen Sinn.
Formate und relevante Schema-Typen: JSON-LD, Microdata und RDFa
Drei Formate können strukturierte datentechnisch umsetzen, doch sie unterscheiden sich deutlich in Praxistauglichkeit. JSON-LD liegt als eigenständiger Codeblock im Head- oder Body-Bereich und lässt sich unabhängig vom sichtbaren HTML pflegen. Microdata verschachtelt Attribute direkt im HTML-Markup, was Wartung und Templating erschwert. RDFa funktioniert ähnlich wie Microdata, stammt aber aus einem anderen Standardisierungsumfeld und wird seltener in modernen CMS-Systemen unterstützt.
Google empfiehlt JSON-LD als bevorzugtes Format, unterstützt aber alle drei Varianten. Für die meisten Projekte ist JSON-LD die richtige Wahl, weil es sich leichter generieren, testen und in bestehende Build-Prozesse integrieren lässt.
Gängige Typen je nach Seitenart:
- Article für Blogbeiträge und redaktionelle Inhalte
- Product für Shopseiten mit Preis- und Verfügbarkeitsdaten
- FAQPage für Frage-Antwort-Bereiche
- Event für Veranstaltungen mit Ort und Datum
- LocalBusiness für Unternehmensstandorte
- Dataset für offene Datensätze und Forschungsinhalte
Für sehr große Kataloge, etwa tausende Produkte, lohnt sich zusätzlich ein Blick auf site-level Feeds über das Schema.org Feeds Konzept, statt jede Seite einzeln zu markieren.
Praxis-Implementierung: Schritt-für-Schritt-Anleitung mit Beispiel-JSON-LD
Die Umsetzung folgt einer klaren Reihenfolge, die sich in jedem Projekt wiederholen lässt:
- Ziel definieren: Welches Rich Result oder welche Entity-Darstellung soll erreicht werden?
- Passenden Schema-Typ wählen, der die Seite am genauesten beschreibt.
- Pflichtfelder recherchieren und mit echten, sichtbaren Inhalten füllen.
- JSON-LD-Block erstellen und im Head oder vor dem schließenden Body-Tag einbinden.
- Mehrsprachige Varianten abbilden, falls die Seite in mehreren Sprachen existiert.
Ein kompaktes Beispiel für ein Produkt sieht so aus:
{
  "@context": "https://schema.org/",
  "@type": "Product",
  "name": "Beispielprodukt",
  "image": "https://example.ch/bild.jpg",
  "description": "Kurze Produktbeschreibung",
  "sku": "ABC123",
  "offers": {
    "@type": "Offer",
    "priceCurrency": "CHF",
    "price": "49.90",
    "availability": "https://schema.org/InStock"
  }
}
Der @context verweist auf das Schema.org Vokabular, @type legt den Typ fest, und die restlichen Felder bilden die konkreten Eigenschaften ab. Bei dynamischen Seiten, etwa in einem Produktkatalog, wird dieser Block üblicherweise über ein Template generiert, das die Werte aus der Datenbank zieht statt sie statisch zu pflegen. Für mehrsprachige Websites braucht jede Sprachversion ihren eigenen, konsistenten Block mit den jeweils übersetzten Werten.
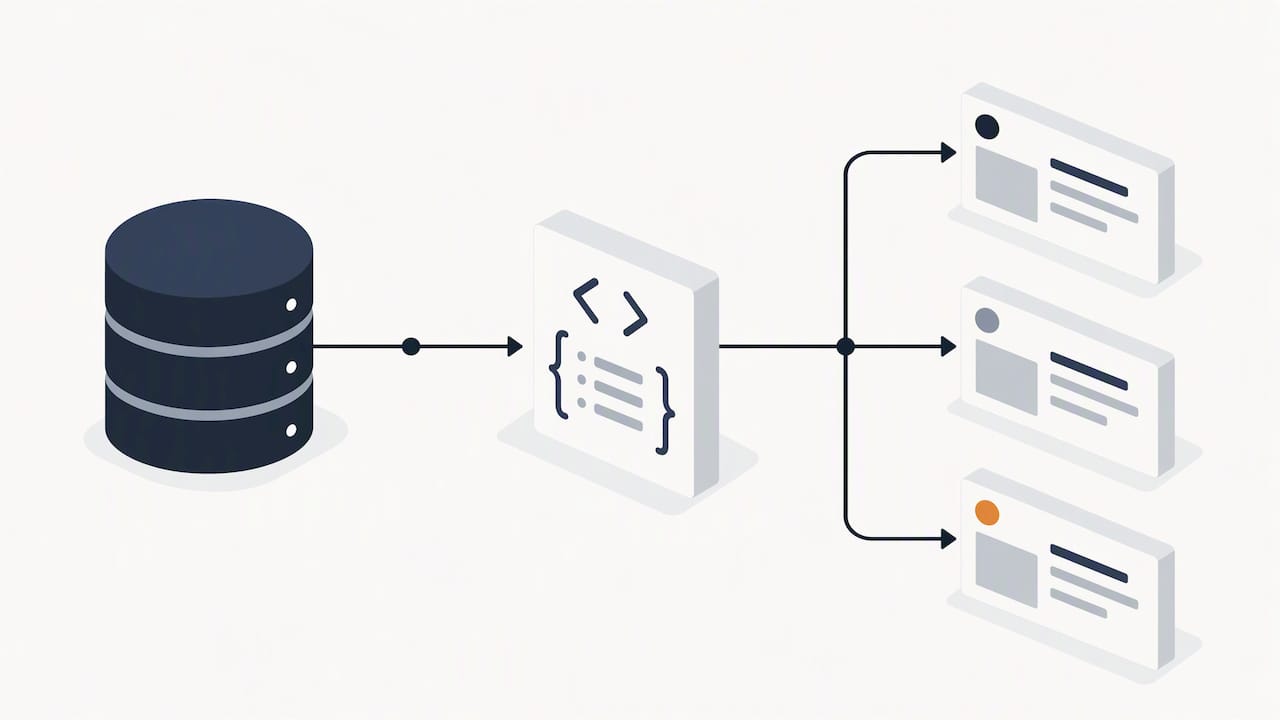
Profi-Tipp: Pflegen Sie das JSON-LD-Template zentral im CMS, statt es pro Seite händisch zu kopieren, sonst drohen bei Änderungen Inkonsistenzen über hunderte Seiten.
Testen, validieren und überwachen: empfohlene Tools und Prüfablauf
Jede Implementierung sollte denselben Prüfablauf durchlaufen, bevor sie live geht. Zuerst eine lokale Prüfung der JSON-Syntax, dann ein Test im Rich Results Test von Google, der zeigt, ob die Seite für ein Rich Result qualifiziert. Parallel lohnt sich der Schema Markup Validator, der das Markup gegen das vollständige Schema.org Vokabular prüft, unabhängig davon, ob Google die Daten für ein Rich Result nutzt.
Die Tools haben unterschiedliche Einsatzfälle:
- Rich Results Test prüft speziell Google-relevante Rich-Result-Eignung
- Schema Markup Validator prüft die technische Korrektheit gegen das gesamte Vokabular
- Search Console liefert fortlaufendes Monitoring über tatsächlich erkannte strukturierte Daten und Fehler im Zeitverlauf
Nach dem Deployment reicht eine einmalige Prüfung nicht aus. Sinnvoll sind regelmäßige Kontrollen, etwa nach jedem größeren Template-Update, sowie Alerts in der Search Console, die auf neue Fehler hinweisen. Wer ein technisches SEO Audit durchführt, sollte strukturierte Daten als festen Prüfpunkt in die Checkliste aufnehmen.
Best Practices und häufige Fehler vermeiden
Die wichtigste Regel steht in den allgemeinen Richtlinien von Google: Das Markup muss den sichtbaren Inhalt der Seite widerspiegeln. Verstecktes oder irreführendes Markup, auch bekannt als Markup-Spamming, kann zu manuellen Maßnahmen führen und die Sichtbarkeit der gesamten Domain gefährden.
Weitere Fehlerquellen, die in der Praxis immer wieder auftreten:
- Falsche oder relative URLs in Bild- und Link-Properties
- Falsche Datentypen, etwa Text statt Zahl bei Preisangaben
- Bilder ohne öffentliche Zugänglichkeit, die der Crawler nicht laden kann
- Zu viele halbleere Properties statt wenigen, vollständig ausgefüllten Pflichtfeldern
Besser ist es, sich auf die Pflichtfelder eines Typs zu konzentrieren und diese korrekt zu füllen, statt möglichst viele optionale Properties oberflächlich zu befüllen. Schema.org selbst folgt dabei einem pragmatischen Prinzip: Laut der Datenmodell-Dokumentation ist unvollständige, aber korrekte Information besser als keine.
Profi-Tipp: Führen Sie vor jedem Release eine kurze Checkliste durch: sichtbarer Inhalt deckt sich mit Markup, alle Pflichtfelder sind gefüllt, Bilder sind öffentlich erreichbar.
Praktische Tools, Plugins und Developer-Ressourcen
Für die tägliche Arbeit reichen wenige, aber verlässliche Werkzeuge. validator.schema.org prüft Markup gegen das vollständige Vokabular, während der Rich Results Test speziell Google-Darstellungen simuliert. Beide sollten in jedem Deployment-Prozess verankert sein.
In gängigen CMS-Systemen lässt sich JSON-LD meist über ein zentrales Head-Template einbinden, das Werte dynamisch aus den jeweiligen Inhaltstypen zieht. Plugins für strukturierte Daten existieren als eigene Kategorie in praktisch jedem größeren CMS-Ökosystem, ein direkter Markenvergleich ist dabei weniger wichtig als die Frage, ob sich die Ausgabe zentral pflegen lässt.
Als Referenz lohnen sich:
- Die Schema.org Dokumentation für Typen und Properties
- Die Google Structured Data Guides für Google-spezifische Anforderungen
- Die Schema.org Feeds Spezifikation für große Datenmengen
Outwork-Perspektive: Vorgehen, KPIs und messbarer Nutzen
Projekte zu strukturierten Daten begleiten viele Anbieter in drei Schritten: Strategie und Typauswahl, technische Implementierung inklusive Validierung, laufendes Monitoring. Relevante KPIs sind die Klickrate der betroffenen Seiten, die Impressionen für Rich Results in der Search Console, die Zitierbarkeit von Entitäten in Answer Engines und die Reduktion technischer Markup-Fehler über die Zeit.
Warum die meisten Teams strukturierte Daten falsch priorisieren
Viele Unternehmen behandeln Schema.org als technisches Nebenprojekt, das am Ende eines Website-Relaunchs noch schnell nachgezogen wird. Das ist die falsche Reihenfolge. Strukturierte Daten sind kein Add-on, sondern ein redaktionelles und strategisches Thema, das mit der Content-Planung beginnt, nicht mit dem Deployment.
Die verbreitete Annahme, mehr Markup bringe automatisch mehr Sichtbarkeit, hält der Praxis nicht stand. Entscheidend ist nicht die Menge der ausgefüllten Properties, sondern die Konsistenz zwischen sichtbarem Inhalt und Markup, dazu die Vollständigkeit bei den Pflichtfeldern. Ein Unternehmen, das zehn Seitentypen oberflächlich markiert, steht schlechter da als eines, das drei Typen vollständig und korrekt abbildet.
Unterschätzt wird zudem die Rolle strukturierter Daten für KI-Sichtbarkeit. Während viele SEO-Teams noch ausschließlich auf Rich Snippets schauen, entscheidet die Qualität der Entity-Daten zunehmend darüber, ob ein Unternehmen in Antworten von Answer Engines überhaupt auftaucht. Wer jetzt saubere Grundlagen legt, verschafft sich einen Vorsprung, der sich erst in den kommenden Jahren voll auszahlt.
— Outwork
Implementierung und Optimierung strukturierter Daten als Service
Viele Teams besitzen die Entwicklerkapazität, um Schema.org korrekt umzusetzen, doch es fehlt oft an Zeit, die Templates für alle Seitentypen konsistent zu pflegen und laufend zu validieren. Outwork übernimmt diese Arbeit als Teil der individuellen Webentwicklung und der SEO Agentur Schweiz Leistungen, von der Typauswahl über die technische Einbindung bis zum laufenden Monitoring.

Ein integrierter Ansatz aus Entwicklung und Suchmaschinenoptimierung verhindert die häufigste Fehlerquelle: Markup, das technisch korrekt ist, aber nicht zur Content-Strategie passt. Wer strukturierte Daten nicht isoliert, sondern als Teil der gesamten digitalen Architektur plant, bekommt am Ende konsistente Ergebnisse über alle Seitentypen hinweg. Wer die Umsetzung jetzt prüfen lassen möchte, kann direkt eine Anfrage über Outwork stellen.
FAQ
Was ist structured data?
Structured Data bezeichnet maschinenlesbares Markup, meist im JSON-LD-Format, das Inhalte einer Webseite in einer standardisierten Struktur beschreibt. Es hilft Suchmaschinen und KI-Systemen, Informationen wie Preise, Bewertungen oder Veranstaltungsdaten korrekt zuzuordnen.
Welche SEO-Arten gibt es?
SEO lässt sich grob in technisches SEO, Content-SEO und Offpage-SEO unterteilen, wobei strukturierte Daten zum technischen Bereich gehören. Ergänzend gewinnen Answer Engine Optimization und Generative Engine Optimization an Bedeutung, da sie die Sichtbarkeit in KI-gestützten Suchsystemen adressieren.
Was heißt schema auf Deutsch?
Schema bedeutet im Deutschen so viel wie Muster oder Vorlage, im Kontext von Schema.org steht es für ein standardisiertes Datenmodell mit festgelegten Typen und Eigenschaften. Das Vokabular umfasst laut Schema.org Dokumentation rund 826 Typen und 1.540 Properties.
Was sind semi-strukturierte Daten?
Semi-strukturierte Daten liegen zwischen vollständig unstrukturierten Texten und streng tabellarischen Datenbanken: Sie besitzen eine gewisse Ordnung, etwa durch Tags oder Schlüssel-Wert-Paare, ohne ein starres Schema. JSON-LD-Markup auf Webseiten ist ein typisches Beispiel, da es definierte Felder nutzt, aber flexibel in bestehenden HTML-Code eingebettet wird.
Muss ich Schema.org-Markup ständig aktualisieren?
Ja, Markup sollte bei jeder inhaltlichen Änderung der Seite mitgepflegt werden, etwa bei neuen Preisen oder geänderten Veranstaltungsdaten. Veraltetes Markup, das nicht mehr zum sichtbaren Inhalt passt, verstößt gegen die Google Richtlinien und kann die Rich-Result-Eignung kosten.